
今天要聊的这个开源写作SKILL,它不让AI直接模仿,而是先让AI系统地把一批文章”拆了揉碎了”,提取出一套可以反复复用的规则,再用这套规则去指导写作。
这就是 writing-dna-skill——一个可以给任意作者做”写作DNA检测”的Agent Skill。
项目简介
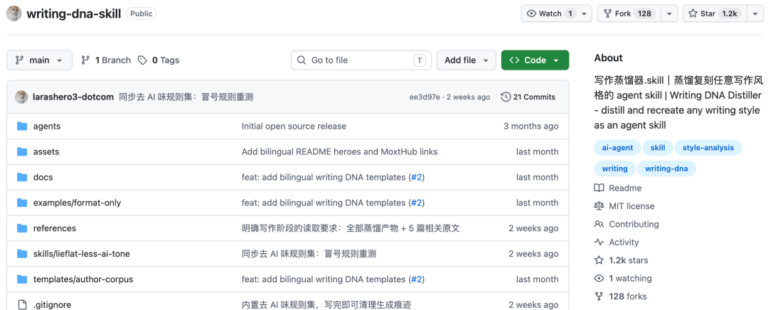
writing-dna-skill(中文名叫”写作蒸馏器”)是一个开源的Agent Skill,由 GitHub 用户 larashero3-dotcom 开发,目前已经在 GitHub 上拿到了 1.2K Star。
简单说,它做的事情是:
给AI 20篇以上的完整文章,让它把这个作者/账号的写作风格拆解成一份”写作DNA报告”,包括语言习惯、文章结构、选题逻辑、素材偏好、认知框架甚至视觉风格——然后以后每次写作前,让AI先把这份DNA报告读一遍,再动笔。
这不是微调模型,也不是训练新的AI人格。
它只是一套流程规范——告诉Agent应该按什么顺序、用什么方法去分析一堆文章,然后把分析结果存成一堆Markdown文件。以后写作的时候,Agent先读这些文件,再干活。
为什么之前的方法不管用?
让我们先搞清楚,”让AI模仿风格”为什么经常失败。
传统做法通常是这样的:
Step 1: 找3-5篇范文
Step 2: 把范文塞进prompt
Step 3: 说一句"请参考以上范文的风格写一篇XX"
问题出在哪?
第一,样本量太少。 3-5篇文章里偶然出现的写法,会被AI当成”固定风格”。比如这个作者某天心情好用了三次感叹号,AI就以为他每篇文章都要感叹。
第二,只看表面不看本质。 AI能模仿的只有”词、句、段落”这种表层特征。但真正让一个作者”像他自己”的东西,其实藏在更深的地方——他为什么选这个话题?为什么从这个角度切入?为什么引用A的数据而不是B的?这些东西,AI靠几篇范文是悟不出来的。
第三,注意力容易涣散。 文章越长,AI越容易”忘记”开头要模仿风格这件事。写着写着就回到AI自己的表达习惯上去了。
writing-dna-skill的做法,相当于把这三个问题都解决了。
核心亮点
这个项目最有意思的地方,是它不把”风格”当成一个模糊的感觉,而是把它拆成了六个层次来逐层分析。我觉得这是整个项目最精华的设计。
来看这张表:
| 层次 | 分析对象 | 提取方法 | 输出形式 |
|---|---|---|---|
| L1 表层语言 | 词频、句长、标点、修辞 | 脚本统计 | 词频表 + 句式清单 |
| L2 文章结构 | 开头hook、正文架构、结尾收束 | 人工标注 | 结构模板(按类型分类) |
| L3 选题逻辑 | 发布时机、切入角度、话题优先级 | 归纳分类 | 选题判断树 |
| L4 素材策略 | 引用来源、权威对象选取、数据使用 | 阅读归纳 | 素材偏好清单 |
| L5 认知框架 | 世界观、价值判断、核心假设 | 深度阅读 | 核心命题列表 |
| L6 视觉风格 | 配图策略、排版、字体、色彩 | 图文统计 + 截图采样 | 视觉风格指南 |
这六层的关系可以浓缩成三句话:
- • L1-L2:解决”怎么写” ——语言习惯和文章骨架
- • L3-L5:解决”怎么想” ——选题逻辑、素材策略、认知框架
- • L6:解决”怎么呈现” ——图文搭配和视觉风格
缺了哪一层都不行。
只复刻L1-L2,写出来会”读着像但想法不像”——表面语气对了,但说的话不是那个作者会说的。只复刻L3-L5,会”框架像但语气不像”——道理对了,但说话方式不对。忽略L6,做图文内容就会”文字像但看着不像”——公众号读者一眼就能看出排版不对。
这个六层拆分,在我看过的所有”风格复刻”方案里,是最系统、最扎实的一个。
它能分析出什么
说了这么多,具体会生成什么东西?来看一个完整的蒸馏产物目录:
作者或账号名称/
├── raw/                      # 原始文章语料(至少20篇)
├── _meta/                    # 元数据标注(每篇文章的标题、日期、类型等)
├── 语言DNA.md                 # ← L1 分析产物
├── 文章结构模板.md             # ← L2 分析产物
├── 写作视角与认知框架.md       # ← L3-L5 分析产物
├── 视觉风格指南.md             # ← L6 分析产物
└── Writing-DNA.md             # ← 最终整合文档(写作时最常用)
每个文件里会写什么?举几个例子你就懂了。
语言DNA.md 里可能会有:
- • 高频动词排行:”指出”、”对比”、”意味着”、”关键是”
- • 平均句长:27字,15字以下短句占38%
- • 标点偏好:破折号使用频率是引号的1.8倍,括号极少
- • 中英文混用模式:技术术语保留英文原词,不翻译
文章结构模板.md 里可能会有:
- • 深度分析类文章结构:”反直觉开篇 → 三个论点展开 → 一个反例 → 总结收束”
- • 评论类文章结构:”新闻事件简述 → 多数观点 → 我的角度 → 为什么别人看错了”
- • 标题习惯:80%标题用”XX其实是XX”句式
写作视角与认知框架.md 里可能会有:
- • 反复出现的核心命题:”技术是双刃剑”、”信息差即价值”
- • 素材偏好:优先引用英文一手来源,不信任二手转述
- • 选题判断树:先看是否有新数据 → 再看是否有反常识角度 → 最后看是否有独特价值判断
这些都是可以被AI直接读取、逐条检查的规则,而不是一段模糊的”请模仿以下风格”prompt。
快速上手
看完原理是不是心动了?来看看怎么用。整个流程非常清晰,核心就三步。
第一步:准备语料
收集目标作者的至少20篇完整文章,放进一个文件夹里。
要求:
- • 文件格式:
.md或.txt都行 - • 数量:至少20篇,建议30-50篇
- • 覆盖不同时期、不同主题、不同类型的文章
- • 如果是图文内容,配图也要保留(很多风格藏在图里)
你可以手动抓取,也可以让Agent帮你从公众号、博客、Newsletter里扒。
第二步:执行蒸馏
把文章放好后,只需要对Agent说一句话:
请使用 writing-dna-skill 蒸馏分析 raw/ 目录里的所有文章。然后Agent会自动按六层流程分析,最后输出那一套Markdown文件。
如果你用的是 Claude Code、OpenClaw、Moxt 这类支持 Skill 的Agent工具,直接 clone 仓库就能用:
git clone https://github.com/larashero3-dotcom/writing-dna-skill仓库本身就是MIT协议开源,没有任何付费门槛。
第三步:用DNA写作
蒸馏完成后,以后想按这个风格写文章,这样跟Agent说:
请先阅读这个作者目录下的所有蒸馏产物,
尤其是 Writing-DNA.md、语言DNA.md、文章结构模板.md。
然后根据这些风格规则,帮我写一篇文章。
主题是:……
如果写出来”不像”,别让Agent自己瞎琢磨,直接让它逐项检查:
请对照 语言DNA.md、文章结构模板.md、写作视角与认知框架.md,
逐项自检刚才的输出,找出不符合风格规则的地方,然后重写。
这一招特别好使——Agent对”逐条检查”的执行力,远比对”整体感觉”的把握要靠谱得多。
它的边界在哪
说了这么多优点,也得讲讲它的局限。这个项目自己也明确写了几个边界:
第一,它不是万能的。 这是一个”Context Engineering”系统,不是模型微调工具。如果你的底层模型本身表达能力有限,DNA再精准也救不了。Skill解决的是”怎么约束模型”,但模型的天花板在那。
第二,语料质量决定上限。 你喂进去的20篇文章如果是作者某一个时期的某一种内容,蒸馏出来的DNA就只能代表那个小切片。想复刻完整风格,就得喂足够多样的样本。
第三,不要用于冒充作者本人。 项目文档里特意写了”重要边界”——这个工具用于学习、分析、风格研究和个人写作资产沉淀,不要用于冒充作者本人、误导读者,或侵犯他人版权。这一点必须遵守。
它能用来干什么
说了这么多,具体有哪些使用场景?
场景一:沉淀自己的写作风格资产。 把自己过去写的公众号文章、博客、Newsletter扒下来蒸馏一遍,以后换了新模型、换了新Agent,直接喂DNA就行,相当于给自己的写作习惯做了一个”备份”。
场景二:分析行业标杆的写作套路。 比如你想研究某科技博主为什么火,把他50篇文章蒸馏一下,你会发现他的选题逻辑、素材偏好、认知框架全都被拆成了明明白白的规则。学习起来比通读他所有文章高效得多。
场景三:让团队写作风格统一。 一个内容团队好几个人写文章,风格各不一样?把团队”定调”的核心文章蒸馏一份DNA,以后所有人写之前都先读一遍,风格统一性会好很多。
场景四:对比不同作者的表达差异。 把两个作者的文章分别蒸馏,然后对比两份DNA——你会清楚地看到:同样一个话题,A喜欢从数据切入,B喜欢从故事切入;A的核心命题是”效率优先”,B的核心命题是”人文关怀”。这种对比本身就是非常有价值的洞察。
写在最后
writing-dna-skill 给我最大的启发,不是”怎么更好地模仿风格”,而是它提供了一套”把模糊感受变成可执行规则”的方法论。
这个思路其实可以复用在很多场景上——不只是写作风格,说话方式、产品审美、代码风格……只要你能找到可以量化、可以拆解的维度,都可以用类似的思路去”蒸馏”,再让AI按蒸馏结果去执行。
对内容创作者来说,这个工具的价值尤其直接,以后每次写作前先读一遍——稳定性和效果都会好很多。
最后放一下项目地址:
👉 GitHub: https://github.com/larashero3-dotcom/writing-dna-skill
📖 相关推荐

资深互联网从业者,专注AI工具研究与实战应用。长期跟踪ChatGPT、Claude、Stable Diffusion等前沿AI技术,擅长将复杂的技术概念转化为通俗易懂的教程。运营颜资源小站,致力于为中文用户提供高质量的AI教程、开源项目推荐和数字资源整理。
评论(0)