
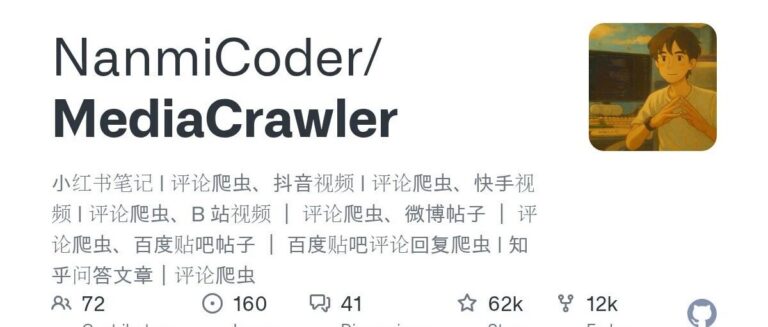
支持小红书、抖音、快手、B站、微博、贴吧、知乎,帖子评论全都能抓。不用逆向,连上 Chrome 就能跑。
6.1 万 Star,GitHub 爬虫类顶流。
MediaCrawler 支持小红书、抖音、快手、B 站、微博、百度贴吧、知乎,帖子和评论都能抓。不用逆向 JS,不用装复杂环境,连上你现有的 Chrome 浏览器就能跑。
我试了一下。配置好关键词,跑起来之后浏览器自动打开对应平台,登录、翻页、抓取,数据自动存到 CSV 或数据库。
01 它支持什么
平台覆盖很全:
- • 小红书:笔记、评论
- • 抖音:视频、评论
- • 快手:视频、评论
- • B 站:视频、评论
- • 微博:帖子、评论
- • 百度贴吧:帖子、评论
- • 知乎:问答、文章、评论
数据可以存成 CSV、JSON、JSONL、Excel,也可以直接写进 SQLite 或 MySQL。
02 它怎么工作的
MediaCrawler 的核心思路是复用浏览器登录态。
传统爬虫要逆向平台的加密算法,生成签名参数,技术门槛高,而且平台一变就要重写。
MediaCrawler 走的是另一条路——用 Playwright 启动浏览器,连接你已有的 Chrome 实例(CDP 模式)。你平时登录过的账号、保存的 Cookie 都能直接复用。
平台的风控主要是针对自动化脚本的。你用真实的浏览器、真实的登录态,风险就低很多。
需要验证码的时候,它会自动调用浏览器截图,等你手动处理。
03 怎么装
三步搞定。
装 uv(Python 包管理器):
curl -LsSf https://astral.sh/uv/install.sh | sh克隆项目,装依赖:
git clone https://github.com/NanmiCoder/MediaCrawler.git
cd MediaCrawler
uv sync
装浏览器驱动(可选,CDP 模式不需要):
playwright install然后配置 config/base_config.py,填上关键词、平台、数据存储方式,跑起来就行。
04 额外功能
除了基础爬虫,还有几个有意思的功能。
HomeFeed 首页信息流。 可以抓取各平台首页推荐的内容,做趋势分析。
AI Agent Skill。 已经适配了 OpenClaw、Claude Code、Cursor,让 Agent 直接调用爬虫能力。基于评论分析的 AI Agent 也在开发中。
自媒体视频下载器。 桌面端工具,适合学习全栈开发。
还有一个 Pro 版本,功能更多,架构也更好,开源版免费用,Pro 版付费订阅。
05 注意事项
这个项目免责声明写得挺清楚——仅供学习研究,禁止商业用途。
爬虫违法违规的案件不在少数,用之前自己判断风险。平台的服务条款也要遵守,别用来做大规模爬取或其他非法行为。
另外,CDP 模式需要你本地有 Chrome 浏览器在跑,而且账号不能是封禁状态。
写在最后
6.1 万 Star,说明很多人有跨平台数据采集的需求。
MediaCrawler 解决的是一个很具体的痛点——不用逆向,不用一个个平台单独写脚本,一个工具全搞定。
如果你需要采集社交媒体数据做分析,这个工具值得装一个。
📖 相关推荐

资深互联网从业者,专注AI工具研究与实战应用。长期跟踪ChatGPT、Claude、Stable Diffusion等前沿AI技术,擅长将复杂的技术概念转化为通俗易懂的教程。运营颜资源小站,致力于为中文用户提供高质量的AI教程、开源项目推荐和数字资源整理。
评论(0)