
现在让 AI 操作浏览器比如去查机票、找资料、填表单等,都可以交给 Agent 去做了。
但大部分实现方案都是每走一步先截图,再让大模型看图了解界面内容后,再点击操作下一步。
这样就会导致一个简单的查询任务,往往都要等很久,还不如自己动手快。
昨天刚聊过一款只做判断、不写文字的模型 Jev,几百毫秒就能给出「选哪个」的答案。
而这个浏览器操作的「下一步该点哪个按钮」,实际上也算是一道选择题,需模型做出答案。
在 Jev 刚发布时,Browser Use 团队就意识到,它能解决一直以来 Agent 操作浏览器慢的问题。
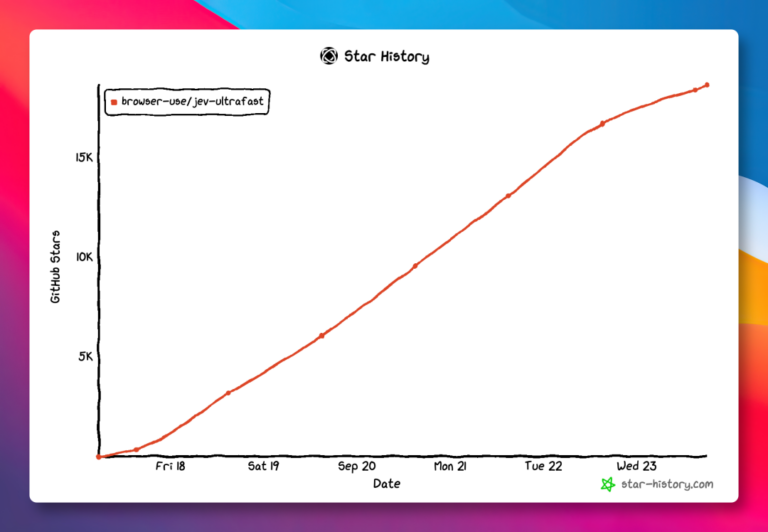
然后立马基于 Jev 做了一个新的浏览器 Agent:jev-ultrafast,并开源已斩获 19000+ Star。
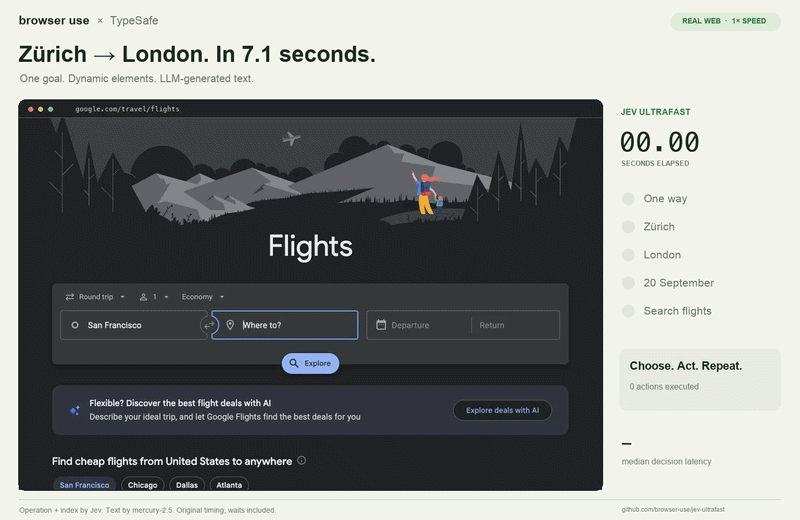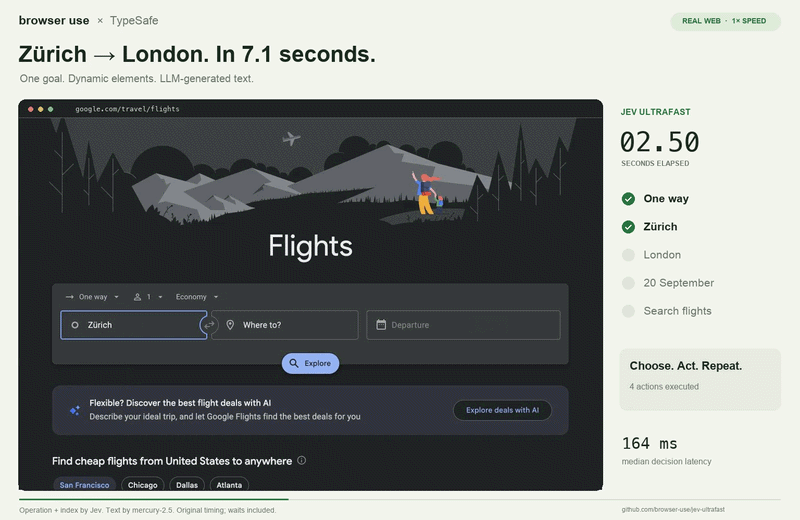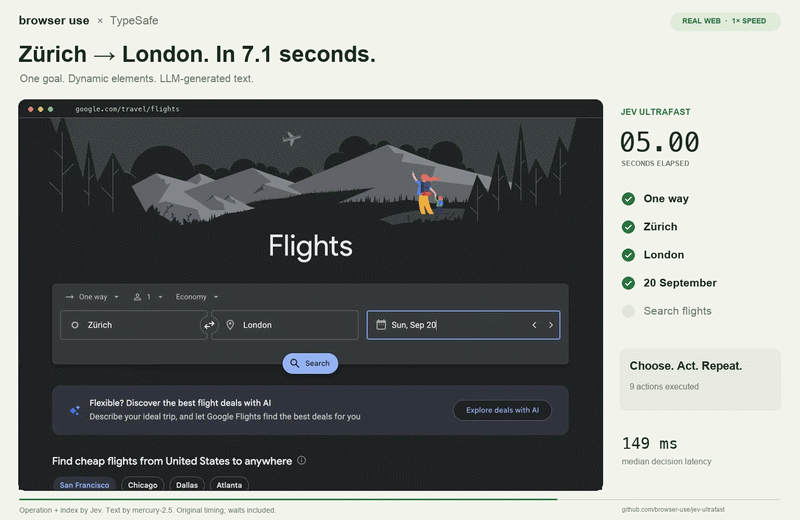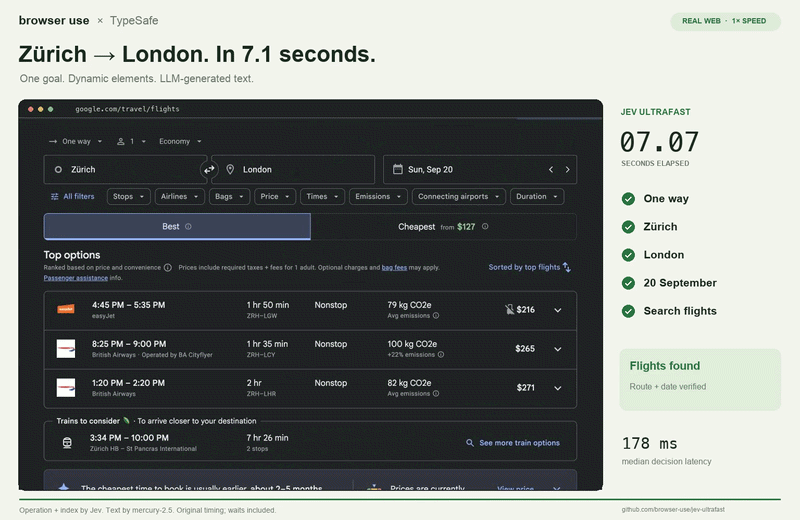
在官方的演示案例里,让它在 Google Flights 上查 9 月 20 日苏黎世飞伦敦的单程机票。
从填写出发地、目的地、选日期,到页面刷出航班列表,全程只用 7.07 秒,视频以原速实录。
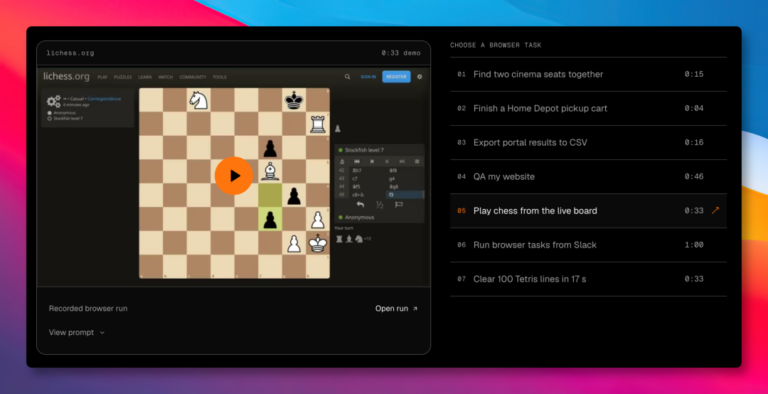
换个任务也一样很快,同一套逻辑去维基百科打开「哥德尔不完备定理」的词条,仅用 2.8 秒。
在一个本地搭的酒店网站上,搜索里斯本、勾上三项筛选条件、打开指定酒店,只用了 1.9 秒。
这几个任务都没有针对网站写专用脚本,跑的都是同一个 Agent。
消耗 Key 的价格非常低,共处理了约 9 万个输入 token,按公开价格算大约就 0.0039 美元。
能这么省,正是因为它只把屏幕上看得见的文字交给模型,屏幕外的正文、页脚都不会塞进去。
那它为什么这么快?我看了一下项目里的代码和 REAMD 文档翻,总结主要靠以下几个设计。
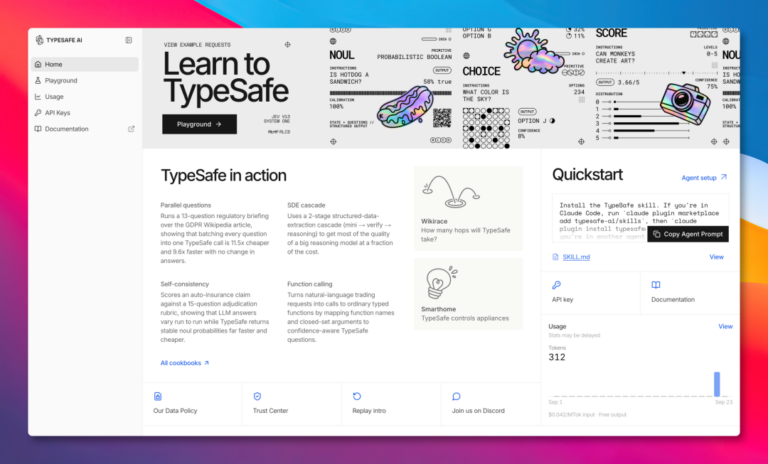
最关键的一点是它不通过截图方式实现,而且把页面上的按钮、输入框、下拉框,整理成一张带编号的元素表。
然后交给 Jev 处理的是一份结构化清单,不用再让模型看图理解页面。
接着在 Jev 的请求里得到两个决定,一个是做什么操作,点击、输入、选择还是滚动,另一个是操作哪个元素。
两个判断共用一次网络往返,这次航班任务一共调用了 17 次 Jev,单次判断的中位耗时只有 178 毫秒。
而且给 Jev 的选项都是当前页面能做的,按钮不会混进输入框的候选里,点错的机会也就少了。
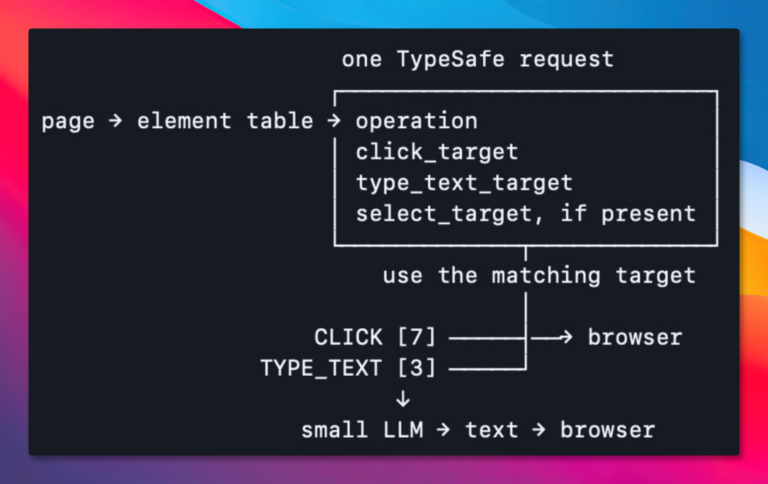
大模型在这里只负责打字,需要输入文字时,才调用一个小语言模型把内容写出来。
比如在出发地一栏写出「Zurich」,只花了 581 毫秒。
速度快了,安全这块也没放松,模型的输出不会直接变成代码、坐标或者命令拿去执行。
每次点击之前,程序都会再核对一遍,这个元素是不是还在、有没有被弹窗挡住,确认没问题才点下去。
跑起来之后,本地还有一个可视化面板,能看到每一步的元素编号、各个操作的概率和实际执行的动作。
想看得更细,还可以切到单步模式,每一步都停下来,确认之后再执行。
想要上手需两把密钥,一把是 TypeSafe 的 API Key 用来调用 Jev,另一把是 OpenRouter 的 Key,给负责打字的小模型用。
项目要求 Python 3.12 以上,用 uv 管理依赖,克隆下来之后几行命令就能跑起来。
git clone https://github.com/browser-use/jev-ultrafast.gitcd jev-ultrafastuv synccp .env.example .envuv run jev
把两把密钥填进 .env 文件,再用浏览器打开 http://127.0.0.1:8766,点「Start demo」就能看它自己跑。
它是通过远程调试连上本机 Chrome 的,第一次运行时 Chrome 会弹窗询问,允许即可。
如果想让它跑自己的任务,也可以当成 Python 库来用,传入一个网址和一句话的目标就行。
该说的问题也说一下,目前它还是一个 MVP,页面里嵌套的 iframe、Canvas 画布、文件上传、新开标签页这些场景还处理不了。
而且 Agent 自己说「完成」也不代表任务一定做对了,官方的航班示例在它停下后,还会单独核对一遍结果。
另外它用的是本机 Chrome 的配置和登录状态,拿来查信息没问题,但建议下单付款还是自己来更稳妥。
写在最后
过去做浏览器 Agent,常见的思路是让一个大模型看截图、想清楚、再动手,每一步都要它从头想一遍。
jev-ultrafast 换了个分工,「点哪里」交给判断模型,「写什么」交给小模型,大模型基本不用出场。
在我看来,这种分工接下来会成为网页 Agent 的常见做法,毕竟网页上的大部分操作,本来就是在几个按钮里挑一个。
七秒查完一趟航班只是开始,等这些场景补齐了,网页上的重复活交给 Agent 去跑,可能比自己动手还快。
GitHub 项目地址:https://github.com/browser-use/jev-ultrafast
📖 相关推荐

资深互联网从业者,专注AI工具研究与实战应用。长期跟踪ChatGPT、Claude、Stable Diffusion等前沿AI技术,擅长将复杂的技术概念转化为通俗易懂的教程。运营颜资源小站,致力于为中文用户提供高质量的AI教程、开源项目推荐和数字资源整理。
评论(0)