
给 AI 一张图片,你就能用上下左右键在图片的画面里走动,转头看看周围,声音也会随着视角变化。
Noiz AI 的 HelixWorld,正在尝试生成这样的交互式世界,目前已经开源了。
先看这几段演示,建议戴上耳机。
不同于文本生成模型、生图生视频的模型。
这种是实时生成可交互的空间世界,太炫酷了。直接打开想象,真不敢想象这项技术后面变成什么样子。。
这让我想起前几年第一次玩 AI 生成视频的时候,当时效果还很拉。
比如史密斯吃面,当时人物的动作和表情还很奇怪。
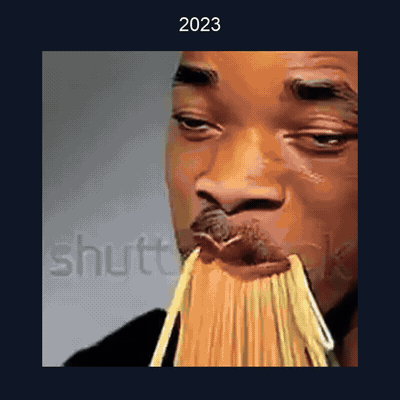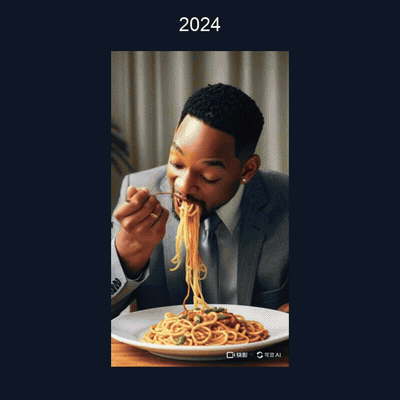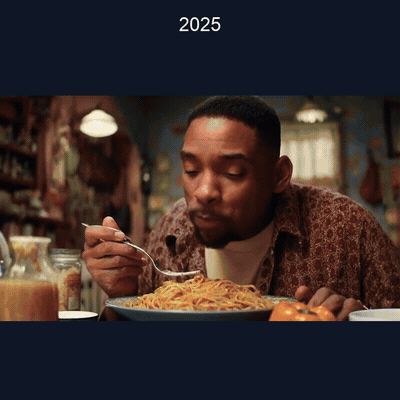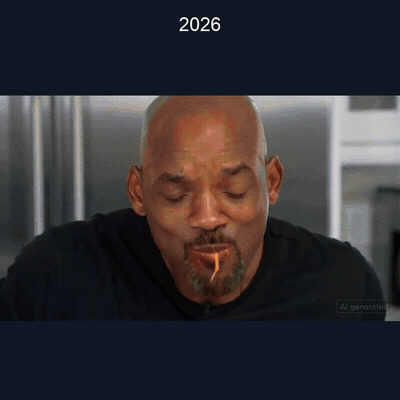
但这几年的发展,视频的画面、动作和镜头表现,已经进步了太多。足够以假乱真了。
现在看到 HelixWorld 这样的探索开源项目,连走动、转头这些操作,都能参与到画面和声音的生成里。
真的很难想象,再过几年,我们会以什么样的方式体验 AI 生成的内容。
01
介绍一下这个开源模型
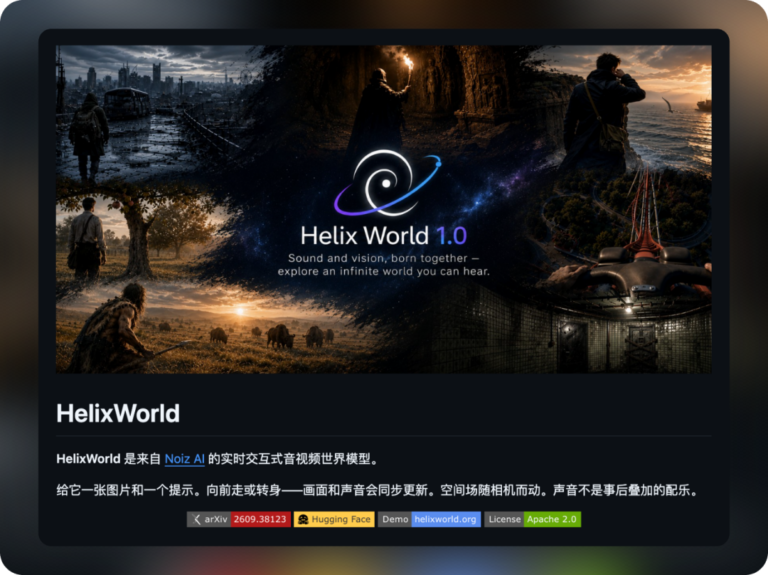
部署完这个 HelixWorld 开源项目,可先选一张起始图片,再用文字描述场景。
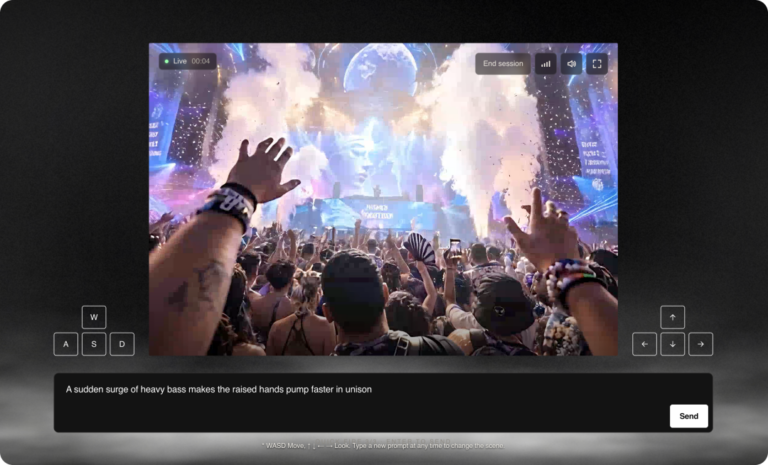
进入世界后,就可以用 W、A、S、D 控制移动,用方向键调整观察方向。
模型会结合当前场景和你的操作,继续生成接下来的画面与声音。
这里的世界模型,做的就是根据已有信息,生成后续所见所闻。
开源地址:https://github.com/NoizAI/HelixWorld看上面这个官方演示,海底那一段。
潜水面罩出现在眼前,鱼群从珊瑚附近游过,镜头随着操作向前移动。
到了雪山场景,视角又变成沿着雪坡向下滑行,前方的山体和树林逐渐展开。
在 AI 生成的场景里,一边走,一边决定接下来看到的是啥、听到的是啥。
能否跟上操作、转头之后场景是否连贯,是体验中很重要的部分。
但我感觉随着模型的发展,一年后会逐渐发展的非常丝滑。。。
而且 HelixWorld 会联合生成视频和音频,并让空间声场跟随视角变化。
比如一个声音原本来自你的左侧,当你转身面向它,声音相对你的方向也应该发生变化。
这种对应关系是能保持的,这也是这个开源项目的核心能力之一。
02
这个模型的原理
要让画面和声音跟着操作变化,模型得先学会它们之间的关系。
训练用的视频里,除了画面,还包含真实立体声和相机运动信息。
这样,模型才能同时学习镜头怎么移动、场景怎么变化,以及声音如何与画面对应。
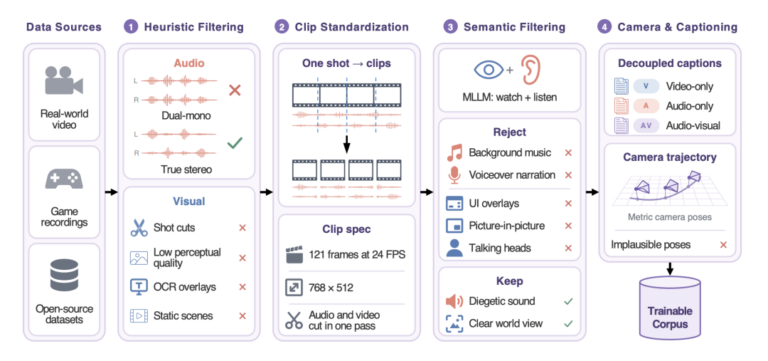
文字描述也会分别说明视觉内容、声音,以及两者的联系。
拿森林行走举例,可以分别描述林间小路、脚步和树叶声,再说明人物正在沿着小路向前走。
这些描述帮助模型把动作、画面和声音联系起来。
在生成时,起始图片确定场景,文字补充要求,用户的移动和转向则不断加入后续生成过程。
画面与音频会共同生成,声音也因此能够响应视角的变化。
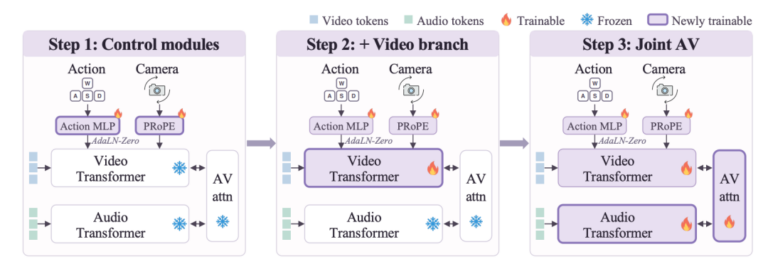
要跟上交互速度,还得减少生成所需的时间。
团队采用了模型蒸馏,让一个生成步骤更少的模型,学习原来模型的生成能力。
可以理解为,尽量用更少的计算步骤,把后面的声画接出来。
生成得越长,前面积累的误差也越可能影响后面的内容。
因此,模型还会参考前面的片段,并通过专门训练,减少长时间生成中的画面漂移和声音退化。
在单张 NVIDIA H800 上,模型热身后进入连续生成阶段,能够以 768 × 512 的分辨率实现 24 FPS 的实时声画生成。
技术报告:https://arxiv.org/abs/2609.3812303
如何体验部署
打开官网,选择示例图片或者上传自己的图片,再填写场景描述。
就能生成一个你可以探索的世界。
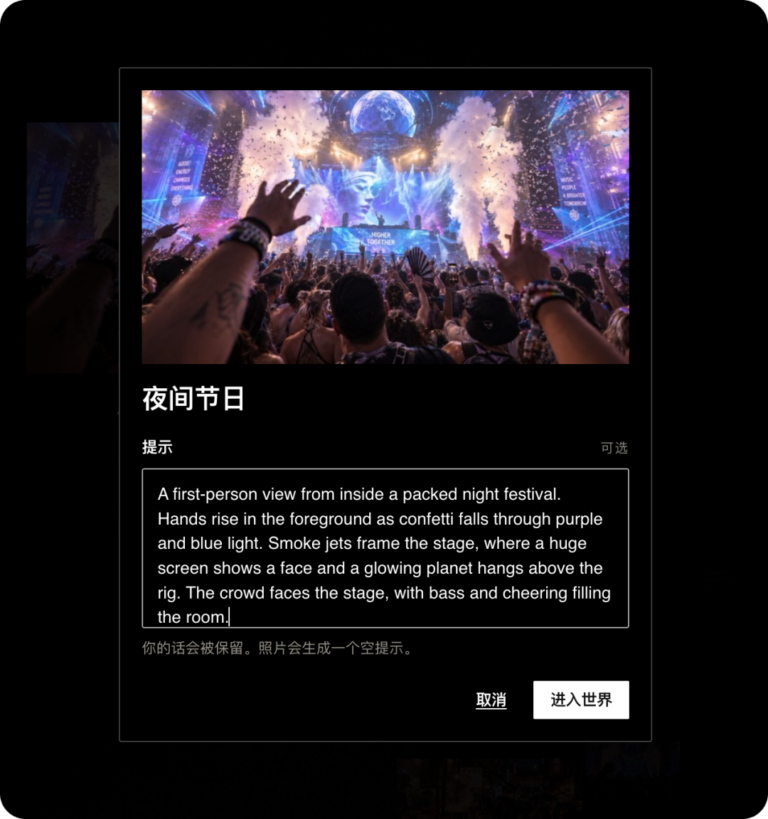
进入世界后,用 WASD 移动、方向键转动视角,观察画面怎样继续生成。
网页还支持在运行过程中修改提示词,尝试调整后续场景。
如果想在本地运行,需要准备 Linux、Python 3.11、CUDA 12.x,以及 NVIDIA 显卡。
官方建议使用 80 GB 显存,系统中还需要提前安装 ffmpeg 和 ffprobe。
这个配置要求比较高,普通电脑更适合先体验网页 Demo。
环境准备好后。
下载项目、安装依赖,再下载模型:
git clone https://github.com/NoizAI/HelixWorld.gitcd HelixWorldconda create -n helixworld-preview python=3.11 -yconda activate helixworld-previewpython -m pip install -r requirements.txtpython download_models.py
例如,把一张森林图片保存为项目目录下的 forest.png。
分别写清画面、声音,以及它们之间的关系,再安排前进、右转和停止:
CUDA_VISIBLE_DEVICES=0 ./run.sh--image forest.png--video-prompt "A first-person view moving along a forest path."--audio-prompt "Footsteps on dirt, rustling leaves and distant birds."--av-prompt "Walking through a forest with footsteps and forest ambience."--actions "W:5,right:5,stop:5"--perspective first_person--num-frames 121--output-dir outputs/forest
动作后面的 5 表示模型的控制步数,并非 5 秒。
这组设置会生成 121 帧,输出的 MP4 保存在 outputs/forest/release/native/。
想换个场景时,可以更换起始图片,再调整画面和声音的描述。
目前公开预览版的本地入口主要用于离线生成,需要先写好动作序列,再得到视频。
浏览器里的实时交互,可以通过官网 Demo 体验。
开源地址:https://github.com/NoizAI/HelixWorld模型下载:https://huggingface.co/NoizAI/HelixWorld-preview在线体验:https://helixworld.org技术报告:https://arxiv.org/abs/2609.38123
📖 相关推荐

资深互联网从业者,专注AI工具研究与实战应用。长期跟踪ChatGPT、Claude、Stable Diffusion等前沿AI技术,擅长将复杂的技术概念转化为通俗易懂的教程。运营颜资源小站,致力于为中文用户提供高质量的AI教程、开源项目推荐和数字资源整理。
评论(0)