
现在的声音克隆工具,好像一直没跳出一个怪圈:要么是订阅制云端服务,好用但贵、还要担心隐私;要么是开源的 Python 项目,免费但难装、环境地狱。
两边都不痛快。
直到我撞见了 YoVoice。
项目简介
YoVoice 是一个叫 leemysw 的开发者在 GitHub 上开源的本地优先音频创作工作室,主打一句话:Give your words a voice. Compose your ideas into songs.
翻成大白话就是:给你的文字配上声音,把你的想法谱成歌曲。
它是一个完整的桌面应用 + CLI + MCP 服务三件套,定位很清晰——在本地跑通从”文字→语音→歌曲→乐谱”整条生产链。
支持 macOS 和 Windows 双平台覆盖。
02
PART
它有什么不一样?
YoVoice 最狠的地方,是它同时解决了前面说的两个痛点:云端的贵和隐私问题,以及开源项目的环境地狱问题。
零云调用、零按字符计费
所有推理都在你本地跑——用你的 GPU 或 CPU,不走任何云端 API。
你的参考音频、配音文稿、生成的歌曲,从头到尾不会离开你的电脑。
这对两类人来说特别戳中要害:
隐私敏感的创作者 比如想克隆已故亲人声音的人,或者需要制作涉及商业机密的企业宣传片的配音,数据就是命根子
高频内容生产者 有声书主播、AI 漫剧团队、短视频运营,每天要生成几百上千句配音,云 API 的账单会按月线性爆炸
原生 C++,彻底告别 Python 地狱
这是 YoVoice 跟所有同类项目最大的分水岭。
市面上的开源 TTS 项目,基本都是 Python + PyTorch 栈。好处是模型容易训,但坏处也是显而易见的:装个环境要半小时起步,版本冲突能搞到怀疑人生,打包发布也是一团糟。
YoVoice 换了个思路——底层用 audio.cpp(一个开源的本地音频推理引擎),用 C++ 重写了整个推理链路。桌面端是 Tauri 壳,前端用 React,双击 .dmg 或 .exe 就能跑。
官方给的参数很实在:
Windows 安装包直接内置 CUDA 12.4/13.3 运行时,解压完就能吃满 NVIDIA GPU
macOS 原生跑 Metal,Apple Silicon 用户打开即用
没有 Conda,没有 pip install,没有 torch 版本冲突
不只是配音,还能直接作曲
这点是真的让我眼前一亮。
YoVoice 内置了 ACE-Step 1.5 Turbo 音乐生成模型。你可以写:
风格:轻快的民谣,木吉他为主,男声演唱 歌词:[verse] 清晨的阳光洒进窗 / [chorus] 我们去爬山吧 / [verse] 带上你的相机和梦想
然后直接生成一整首歌——带人声、带伴奏、有多个段落。每一次生成都会作为一个”take”保存,你可以在时间线上并排对比,挑最好的那版。
更厉害的是还有 Score 模式。你可以像写五线谱一样按小节写音符,或者让接入的 AI Agent 帮你写乐谱,然后用 General MIDI 音色库渲染出成品。结果是完全可复现的,还能导出成 MIDI 文件给 Logic 或 Ableton 继续加工。
原生 MCP,跟 AI Agent 无缝对接
YoVoice 自带一个 MCP 服务器,可以直接给 Cursor、Claude Code 之类的编程助手调用。
03
PART
支持模型
YoVoice 目前支持10+ 款开源语音和音乐模型,按硬件需求分了三档:
🟢 轻量档:任何 CPU 都能跑
Kokoro-82M 是当家花旦。整个模型才 189MB(Q8 量化版),82M 参数,毫秒级延迟。内置 49-100 种预设音色,支持中文、英文等多种语言。
适合什么场景?快速草稿、旁白配音、跑不通大模型的时候的应急方案。
🟡 高保真档:4-6GB 显存即可
VoxCPM2 2B 参数,48kHz 高采样率。支持文本引导的”声音设计”——你不用录参考音频,直接说”低沉的中年男声,带点烟嗓”,它就能给你造一个。零样本克隆也支持,3 秒参考音频就行。
IndexTTS 2.0/2.5:这两款是目前中文场景里口碑最好的开源模型之一。支持情感控制、跨语种克隆(用中文参考音频说英文)、发音编辑(给多音字标拼音)。
Qwen3-TTS 系列 阿里通义出品,多语言能力强,还支持语音设计。
🔴 音乐生成档:12GB+ 显存
ACE-Step 1.5 Turbo 是音乐生成的主力模型,BF16 精度下 10GB 显存。风格提示词 + 带段落标记的歌词 = 完整歌曲。支持 50+ 种人声语言。
如果你有 16GB 显存或者 Apple Silicon 统一内存 16GB 以上,还可以跑 YuE2 3B,这是目前开源音乐生成里的第一梯队选手。
04
PART
怎么装?
macOS 用户(Apple Silicon)
1
去 GitHub Releases 页 下载 .dmg 文件
2
双击打开,把 YoVoice 拖进 Applications 文件夹
3
第一次打开在系统设置里允许一下(因为是开源开发者签名)
4
进入设置页,点几下下载你需要的模型(Kokoro-82M 最快,189MB 几秒下完)
完了。没有第 5 步。
Windows 用户(NVIDIA GPU)
直接下载带 CUDA 的安装包:
-cuda12.4-setup.exe:兼容性最好,支持老显卡和老驱动
-cuda13.3-setup.exe:体积更小,但需要较新的驱动
如果只有 CPU 或者 AMD GPU,也有对应的普通安装包。
用 CLI 或者 MCP
不想打开桌面界面?直接装 YoVoice Skill 给你的 AI Agent,然后说:
用 voice.wav 作为参考音色,朗读 narration.txt,语气要平静一点,保存成 narration.wav
Agent 会自动在后台调用 CLI,生成好文件给你。
或者运行 yovoice serve 启动 HTTP API 和 MCP 服务,其他机器也能调用。
05
PART
功能到底有多全?
从实际使用的角度,YoVoice 把整个配音和创作流程都铺了一遍:
声音克隆与设计
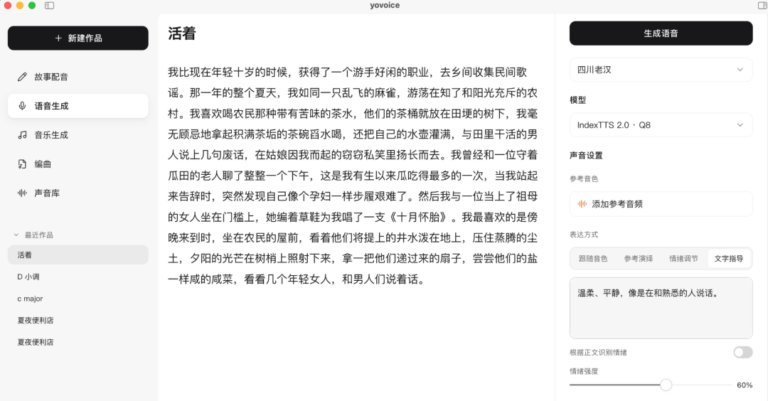
上传 3-10 秒参考音频 → 零样本克隆
用自然语言描述声音属性 → 生成全新音色
导入或用自然语言描述情绪表现 → 控制语气
内置波形编辑器,支持修剪和片段替换
多轨项目管理
支持”故事配音”、”语音生成”、”音乐”、”乐谱”四种项目类型
每个项目可以有多条声线/角色
每次生成作为一个独立”take”保存,支持并排对比
时间线滚动、波形可视化
导出能力
语音导出 WAV / MP3
乐谱导出 MIDI 和分轨 stems
支持 GGUF 格式模型导入(方便从其他工具迁移)
///
LAST
写在最后
如果你符合下面任意一条,YoVoice 值得你花十分钟下载试试:
🎙 内容创作者 播客、有声书、AI 漫剧、短视频配音——高频生成,本地跑省大钱
🎵 独立音乐人/爱好者 想快速把歌词变成 demo,或者玩 AI 作曲的新玩具
🤖 AI Agent 用户 Cursor / Claude Code / Ollama 用户,想让你的 Agent 能”开口说话”
🔒 隐私敏感者 需要在本地处理声纹或商业敏感内容
💻 开发者 想把本地 TTS 集成进自己的应用,或者研究 audio.cpp 的推理框架
如果你只是偶尔生成几句话,或者需要最极致的音色还原,那云 API 可能更合适。但在”够用的质量 + 零成本 + 隐私 + 可自动化”这几个维度上,YoVoice 目前是我见过最均衡的本地方案之一。
GitHub: https://github.com/leemysw/yovoice
📖 相关推荐

资深互联网从业者,专注AI工具研究与实战应用。长期跟踪ChatGPT、Claude、Stable Diffusion等前沿AI技术,擅长将复杂的技术概念转化为通俗易懂的教程。运营颜资源小站,致力于为中文用户提供高质量的AI教程、开源项目推荐和数字资源整理。
评论(0)