
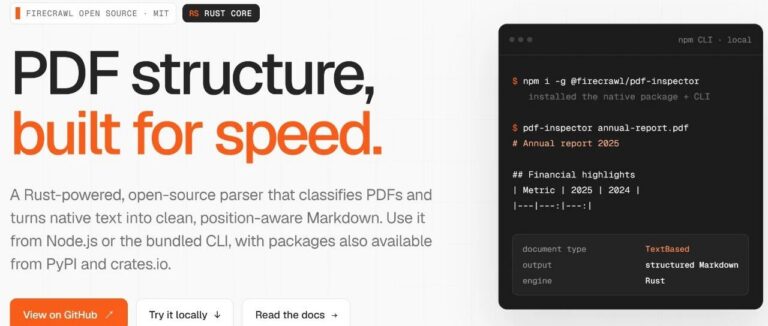
PDF 提取神器 pdf-inspector:10ms 检测类型,文本型 PDF 直接本地提取,扫描件才送 OCR。200 个 PDF 跑完 0.47 秒,比 OpenDataLoader 快 5.5 倍,比 PyMuPDF4LLM 快 3
很多项目把 PDF 当文本处理——不管三七二十一,先送 OCR 再说。
结果:文本型 PDF 白等 10 秒,扫描件还是得 OCR,成本翻一倍,时间翻一倍。
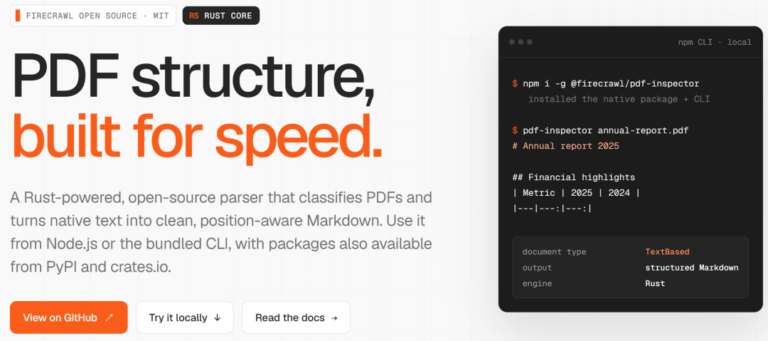
pdf-inspector 是一个 Rust 库,专治这种”一刀切”。
先检测 PDF 类型(10-50ms),文本型直接本地提取(150ms),扫描件才送 OCR(2-10s)。
比 OpenDataLoader 快 5.5 倍,比 PyMuPDF4LLM 快 36 倍。
GitHub:https://github.com/firecrawl/pdf-inspector
01 先搞清楚:不是所有 PDF 都需要 OCR
PDF 分两种:文本型(原生文字)和扫描型(图片扫描件)。
文本型 PDF 本身就有文字数据,直接提取就行,根本不需要 OCR。扫描型 PDF 才是图片,必须走 OCR。
问题是:大多数工具不管三七二十一,全量 OCR。
pdf-inspector 的思路是:先检测,再决策。
PDF 到达
  → pdf-inspector 检测 (~20ms)
  → 是文本型 + 高置信度?
      YES → 本地提取 (~150ms),完事
      NO  → 送 OCR 服务 (2-10s)
大概 54% 的 PDF 是文本型,直接走本地提取,不用花 OCR 的钱和时间。
02 速度对比:碾压级优势
在 opendataloader-bench 基准测试上(200 个 PDF,Apple M4 Pro):
| 引擎 | 总体得分 | 阅读顺序 | 表格 | 标题 | 200 个 PDF 耗时 |
|---|---|---|---|---|---|
| pdf-inspector | 0.875 | 0.915 | 0.814 | 0.788 | 0.47 秒 |
pdf-inspector 不仅最快,准确率也是最高的(Overall 0.875、阅读顺序 0.915、表格 0.814 三项第一)。
03 检测原理:怎么判断要不要 OCR
检测过程极轻量——只解析 xref 表和页面树,不加载完整对象。
扫描策略:
- • 找内容流里的
Tj/TJ(文本操作符)和Do(图像操作符) - • 根据文本操作符的存在与否分类:TextBased / Scanned / ImageBased / Mixed
返回结果包含 per-page OCR routing——不是全有或全无。300 页 PDF 里只有 5 页是扫描件?只送这 5 页去 OCR。
支持多种扫描策略:
- • EarlyExit:碰到第一个非文本页就停止(适合文本型为主的文档)
- • Full:扫描所有页面,精确区分混合类型
- • Sample(n):随机抽 n 页,超大型 PDF 用
- • Pages(vec):只检查指定页码
04 文本提取能力:不只是快,还准确
提取完不只是纯文本,是带结构的 Markdown:
- • 标题层级:H1-H4,靠字体大小比例判断(0.5pt 聚类)
- • 列表:项目符号(•-○)、编号(1.)、字母(a.)自动识别
- • 代码块:等宽字体检测(Courier、Consolas、JetBrains Mono 等)
- • 表格:双线检测——PDF 绘图操作画的矩形 + 文本对齐启发式,双保险
- • 粗斜体:字体名称里的 Bold、Italic、Oblique
- • 多栏布局:报纸式多栏自动检测,按阅读顺序排列
- • CJK 支持:ToUnicode CMap 解码,中文、日文、韩文正常处理
表格检测尤其值得说——同时用 PDF 原生的矩形绘制操作和文本对齐启发式,金融报表、带页码的连续表格都能处理。
05 设计取舍:轻量 = 专注
这个项目有几个地方做得特别实在:
纯 Rust,无 ML,无外部服务。 唯一依赖是 lopdf。没有机器学习模型,不连任何云服务。
单文档加载一次。 检测阶段和提取阶段共用同一个解析后的文档对象,不重复 I/O。
可编译为 WASM。 同一个 Rust 代码可以跑在浏览器里,本地处理 PDF,没有网络延迟。
06 跑起来
Python:
pip install pdf-inspectorimport pdf_inspector
result = pdf_inspector.process_pdf("document.pdf")
print(result.pdf_type) # "text_based", "scanned", "image_based", "mixed"
print(result.markdown) # Markdown 字符串或 NoneNode.js:
npm install @firecrawl/pdf-inspectorimport { processPdf } from '@firecrawl/pdf-inspector';
const result = processPdf(readFileSync('document.pdf'));
console.log(result.pdfType);
console.log(result.markdown);CLI:
cargo install pdf-inspector
pdf2md document.pdf
一行命令跑全流程,10-30 分钟搞定一个项目的首期分析。
写在最后
PDF 提取这件事,很多人还在用”全量 OCR”的老思路。
pdf-inspector 告诉你:先检测,再决策。
54% 的 PDF 根本不需要 OCR,省下这笔钱和时间,剩下的扫描件再走 OCR 也不迟。
11K Star,Firecrawl 出品,两分钟就能跑起来。
📖 相关推荐

资深互联网从业者,专注AI工具研究与实战应用。长期跟踪ChatGPT、Claude、Stable Diffusion等前沿AI技术,擅长将复杂的技术概念转化为通俗易懂的教程。运营颜资源小站,致力于为中文用户提供高质量的AI教程、开源项目推荐和数字资源整理。
评论(0)