
MonkeyOCR v2 开源:0.7B 模型做到多语言文档解析新 SOTA
01 0.7B 参数,多语言文档解析新 SOTA
文档解析这件事,以前的思路是:把通用视觉模型拿来,看看能不能看懂文档。
MonkeyOCR v2 换了思路——专门为文档设计视觉骨干,而不是套用通用模型。
结果:
- • 只有 0.7B 参数(解析器部分 0.6B)
- • 17 种语言文档解析
- • 83.3 综合分,超过 MinerU、docling、marker
02 17 种语言,逐语言基准测试
MonkeyOCR v2 在 17 种语言上做了完整评测:
| 语言 | 分数 | 语言 | 分数 |
|---|---|---|---|
| 英语 | 83.3 | 中文 | 88.6 |
| 日语 | 81.7 | 韩语 | 75.2 |
| 法语 | 84.2 | 德语 | 86.1 |
| 西班牙语 | 87.7 | 葡萄牙语 | 83.2 |
| 俄语 | 84.5 | 阿拉伯语 | 82.1 |
| 印地语 | 75.4 | 泰语 | 78.4 |
| 越南语 | 86.5 | 印尼语 | 87.9 |
| 意大利语 | 87.2 | 土耳其语 | 80.7 |
| 波兰语 | 76.8 |
17 种语言平均 83.3 分。 唯一比它高的只有 3B 参数的 dots.mocr(83.6),但参数多了 4 倍。
03 文档原生视觉骨干是什么?
大多数文档解析模型的做法是:用 CLIP、SigLIP 这类通用视觉模型做图像编码,然后加一个 OCR 头。
问题是——通用视觉模型不是为文档设计的。 它认识猫狗,但看不懂表格结构和阅读顺序。
MonkeyOCR v2 的做法:
- • 文档原生骨干 — 专门用文档数据预训练的视觉 encoder
- • 结构-识别-关系三元组 — 同时解析文档的三种信息
- • 轻量解析器 — 0.6B 的解析头,速度快、部署简单
04 对比同类项目
| 项目 | 参数 | 综合 | 表格 | 阅读顺序 | 协议 |
|---|---|---|---|---|---|
| MonkeyOCRv2 | 0.7B | 83.3 | 88.6 | 86.1 | Apache-2.0 |
| dots.mocr | 3B | 83.6 | 87.4 | 83.3 | — |
| MinerU | — | 83.1 | 87.3 | 85.7 | AGPL-3.0 |
| docling | — | 88.2 | 92.8 | 89.8 | MIT |
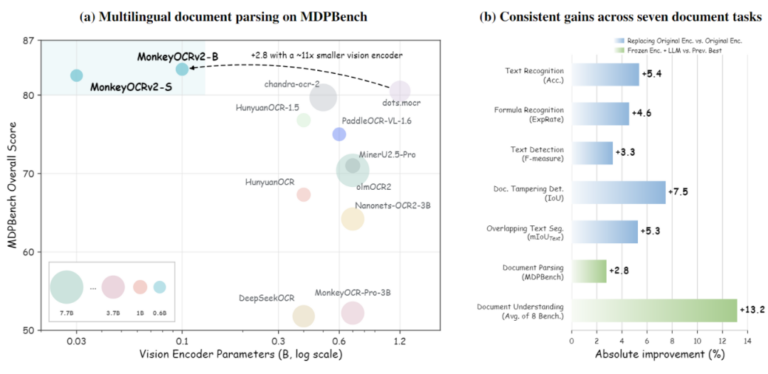
0.7B 做到 83.3,这个效率很高。 MinerU 需要更大的模型才做到 83.1。
05 前身:MonkeyOCR v1 的 6.6K Star
MonkeyOCR v1 去年发布,GitHub 上拿了 6.6K Star。
v2 的升级点:
- • 文档原生视觉骨干(代替通用视觉模型)
- • 多语言支持(从单一的英文/中文扩展到 17 种语言)
- • Apache 2.0(v1 是非商用,v2 可商用)
- • 0.7B 轻量模型(部署门槛低)
06 安装和使用
项目提供 Docker 部署,支持单 GPU 推理。详细步骤见 GitHub README。
07 写在最后
文档解析赛道从去年开始卷起来——MinerU、docling、marker 轮番上场。
但大多数项目的思路是”把通用视觉模型改一改”。
MonkeyOCR v2 换了一条路:从零训练文档原生视觉骨干。
结果 0.7B 参数就做到了 17 种语言新 SOTA。
如果你在用 MinerU 或者 docling,值得试试 MonkeyOCR v2。
Github:https://github.com/Yuliang-Liu/MonkeyOCRv2
论文:https://arxiv.org/abs/2507.02662
📖 相关推荐

资深互联网从业者,专注AI工具研究与实战应用。长期跟踪ChatGPT、Claude、Stable Diffusion等前沿AI技术,擅长将复杂的技术概念转化为通俗易懂的教程。运营颜资源小站,致力于为中文用户提供高质量的AI教程、开源项目推荐和数字资源整理。
评论(0)