
原创 逛逛 2026-04-06 11:34 江西
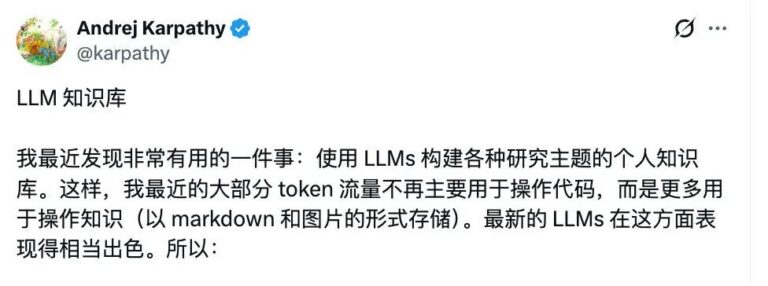
Andrej Karpathy 前两天发了条推文,讲他最近用 LLM 管理个人知识库的一个新玩法。
很多人非常受启发。
然后他把这个思路整理成了一个 Gist,现在已经大几千的 Star 了。
说实话这个思路确实有意思。
而且,从去年年底开始,我也开始基于 LLM + Obsidian 做知识管理。
没怎么打开过 NoteBookLLM 类似这种工具了。
我也没意识到自己怎么就迁移过来了。
感觉是大模型能力(长程 Agent 能力)的提升,和各种实践(渐进式披露等)的出现。
之前很多能被 AI 重塑造的场景再一步步被解锁。
01
一句话说清楚这是什么
Karpathy 提出的核心思路是:
不要把 LLM 当搜索引擎用,而是让它像程序员写代码一样,帮你持续维护一个 Markdown 知识库。
你负责找资料、提好问题,LLM 负责所有的脏活累活:总结、交叉引用、分类整理、保持一致性。
你在 Obsidian 里浏览,LLM 在后台编辑,知识库就像滚雪球一样越滚越大。
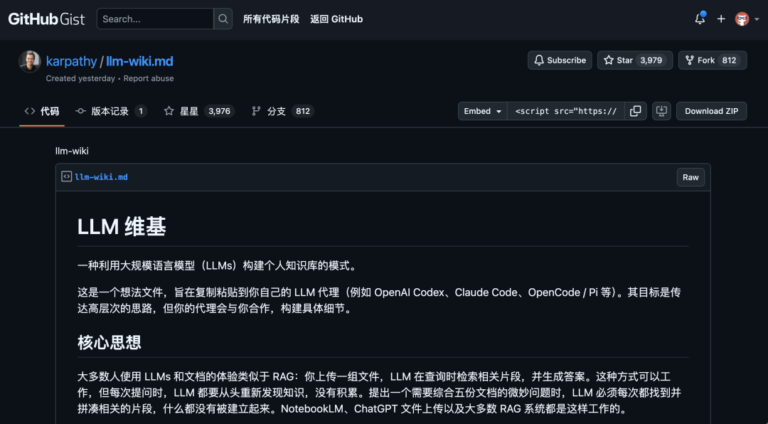
Gist 地址:gist.github.com/karpathy/442a6bf555914893e9891c11519de94f02
为什么传统方式不行
大多数人用 LLM 管文档的方式其实都差不多:
把文件上传上去,每次提问的时候 LLM 检索相关片段,然后生成回答。
这就是大家常说的 RAG 方案。
NotebookLM、ChatGPT 的文件上传、大部分 RAG 系统都是这个套路。
Karpathy 觉得这个方式有个致命问题:没有积累。
每次提问,LLM 都得从原始文档里重新找、重新拼。
你问一个需要综合五篇文档的复杂问题,它每次都得从头来。
问完了,答案就没了,下次还得重新推导一遍。
知识从来没有被真正沉淀下来。
应该让知识复利增长
Karpathy 的方案完全不一样。
他让 LLM 不是每次从原始文档里检索,而是持续地、增量式地构建和维护一个 Wiki:一个结构化的、互相链接的 Markdown 文件集合。
当你往里面添加一个新的资料来源,LLM 不是简单地把它索引进去等着以后被检索。
它会读这个资料,提取关键信息,然后把信息整合进已有的 Wiki 里:更新相关实体的页面、修正主题摘要、标注新数据和旧结论的矛盾之处。
知识编译一次,然后持续保持最新。
这才是关键区别:Wiki 是一个持久的、可复利增长的资产。
交叉引用已经建好了,矛盾已经标记出来了,综合分析已经反映了你读过的所有内容。
每加一个新来源、每问一个好问题,Wiki 都会变得更丰富。
03
三层架构
Karpathy 把整个系统设计成三层。
第一层是 Raw Sources,原始资料层。
你收集的论文、文章、图片、数据文件都放这儿。
这层是不可变的,LLM 只读不写,这是你的搞到的原始数据来源。
第二层是 The Wiki,知识库层。
这是 LLM 生成的 Markdown 文件目录,包括摘要、实体页面、概念页面、对比分析、综述等等。
这层完全由 LLM 拥有和维护,你读它,LLM 写它。
第三层是 The Schema,规则文件。
它告诉 LLM 这个 Wiki 怎么组织、用什么约定、录入来源和回答问题时遵循什么流程。
对 Claude Code 来说就是 CLAUDE.md,对 Codex 来说就是 AGENTS.md。
这是关键的配置文件,让你和 LLM 随着使用不断迭代优化。
04
三个核心操作
整个工作流围绕三个操作展开。
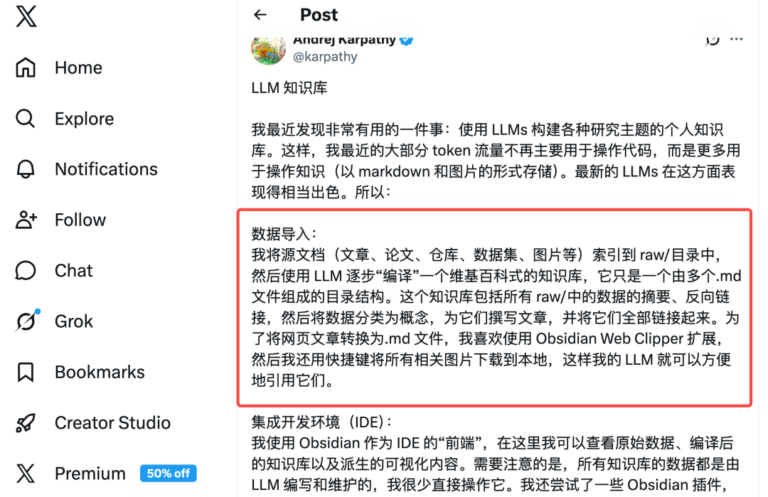
第一个是 Ingest,录入。
你往原始资料目录里丢一个新文件,让 LLM 处理。
LLM 会读这个资料、跟你讨论要点、在 Wiki 里写一个摘要页、更新索引、更新相关的实体和概念页面。
一个来源可能牵动 10 到 15 个 Wiki 页面的更新。
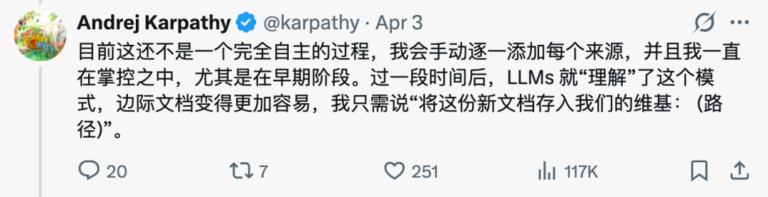
Karpathy 说他喜欢一个一个录入,边录边看,引导 LLM 重点关注意什么。
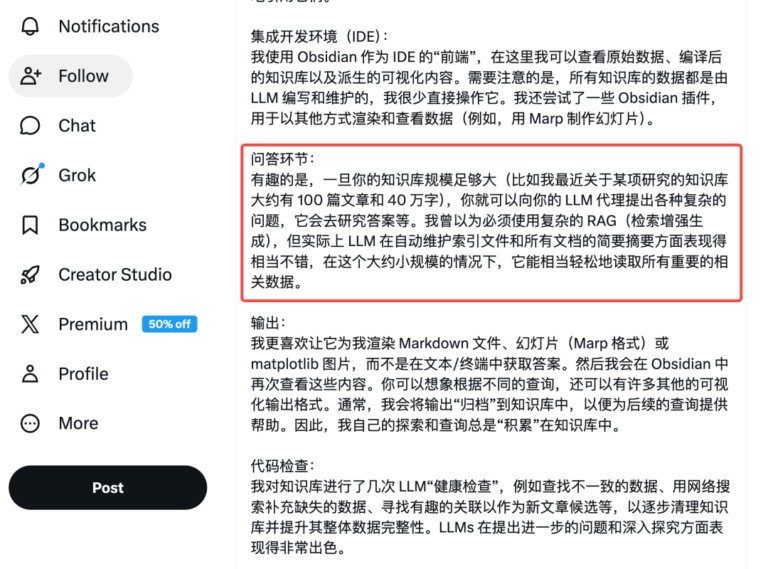
第二个是 Query,提问。
你对着 Wiki 提问,LLM 搜索相关页面后综合回答。
回答的形式可以很多样:Markdown 页面、对比表格、Marp 幻灯片、matplotlib 图表都行。
这里面有一个重要洞察:好的回答可以回存到 Wiki 里,变成新的页面。
这样你每次的探索和提问都在持续丰富知识库,知识在复利增长。
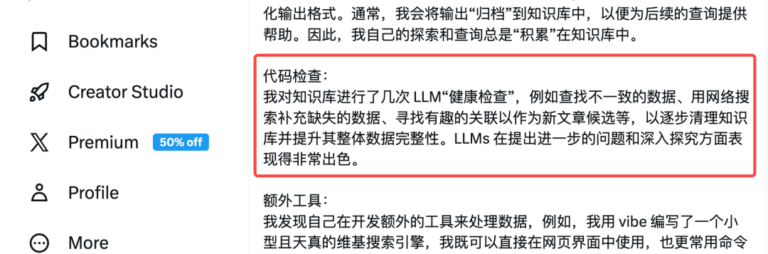
第三个是 Lint,体检。
定期让 LLM 对 Wiki 做健康检查。
找页面之间的矛盾、被新资料取代的过时信息、没有入链的孤儿页面、提到但没有独立页面的重要概念、缺失的交叉引用。
LLM 还很擅长建议你应该去研究什么新问题、找什么新资料。
这一步保证 Wiki 在增长过程中保持健康。
05
实际工作流
Karpathy 的实际用法是这样的:一边开着 Agent,一边开着 Obsidian。
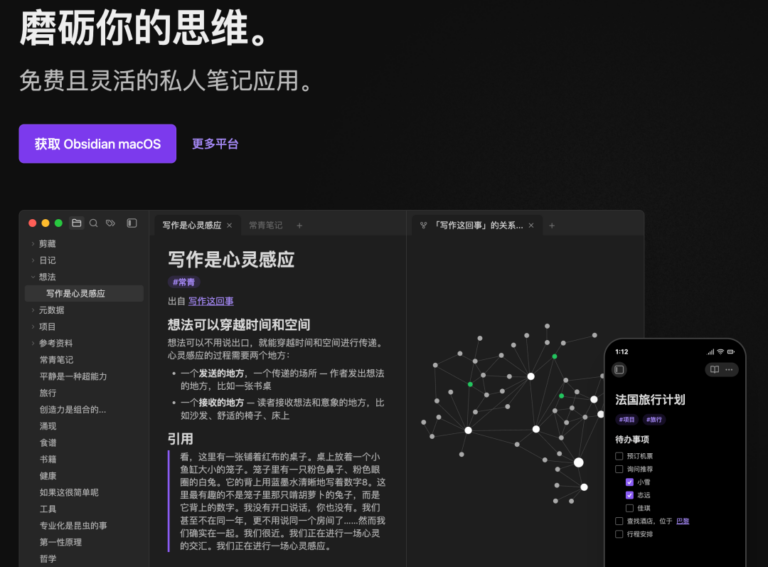
LLM 根据对话内容编辑 Wiki,他在 Obsidian 里实时浏览结果。
跟着链接点点看、看看图谱视图、读读更新后的页面。
用他的话说:Obsidian 是 IDE,LLM 是程序员,Wiki 是代码库。
他还用了几个很实用的工具。
Obsidian Web Clipper 浏览器扩展可以快速把网页文章转成 Markdown。
本地图片下载功能可以让 LLM 直接查看和引用图片。
index.md 做内容目录,log.md 做时间线日志。
有意思的是,在中等规模下:大约 100 个来源、几百个页面,直接靠索引文件就够用了,不需要什么向量数据库或者复杂的 RAG 基础设施。
LLM 先读索引定位相关页面,再深入阅读具体内容,效果就很好。
06
为什么这玩意儿管用
说实话维护知识库最烦人的事从来不是阅读和思考,而是那些琐碎的簿记工作。
更新交叉引用、保持摘要最新、标注新旧数据矛盾、维护几十个页面之间的一致性。
这些活儿人类做着做着就烦了,然后 Wiki 就慢慢荒废了。
人类放弃 Wiki 的原因就是维护负担增长得比价值快。
但 LLM 不会厌倦,不会忘记更新一个交叉引用,可以一次性修改 15 个文件。
维护成本接近零,Wiki 就能一直保持健康。
Karpathy 还提到这个思路跟 1945 年 Vannevar Bush 提出的 Memex 构想精神上是一脉相承的。
一个个人的、精心策划的知识存储,文档之间的关联和文档本身一样有价值。
Bush 没解决的问题是谁来干维护的活儿,LLM 把这事搞定了。
07
GitHub 上已经卷起来了
这个 Gist 发出去之后,各路开发者反应非常快,已经有一堆人在做具体实现了。
有人用 Go 写了个叫 sage-wiki 的工具,一个二进制文件就能跑,支持增量编译、搜索、问答。
还能当 MCP Server 暴露给任何 LLM Agent 用。
开源地址:https://github.com/xoai/sage-wiki有人做了个 Claude Code 的 Skill,一行命令就能装上,直接在 Claude Code 里 ingest 来源。
还有人做了 Thinking-Space,一个专门为这种思维工作流设计的 IDE。
Karpathy 自己也说了,这个 Gist 是一个理念文件,不是具体的代码实现。
在 Agent 时代,你分享思路,别人让各自的 Agent 去定制化搭建就行了。
08
怎么上手
最简单的方式就是把这个 Gist 的内容复制给你的 Agent,让它帮你搭建。
Gist 地址:gist.github.com/karpathy/442a6bf555914893e9891c11519de94f你需要的东西就两样:一个 Agent 和 Obsidian。
Agent 的话 Claude Code、Codex、OpenCode 都行。
可选的工具也有不少:
-
qmd 搜索引擎可以在 Wiki 变大后提供更好的搜索能力。
-
Marp 格式可以直接从 Wiki 内容生成幻灯片。
-
Dataview 插件可以基于页面元数据做动态查询。
-
Obsidian 的图谱视图是看 Wiki 整体形态最好的方式,什么连着什么、哪些页面是枢纽、哪些是孤岛,一目了然。
而且整个 Wiki 本质上就是一个 Git 仓库的 Markdown 文件,版本历史、分支、协作这些都是现成的。
我觉得这个思路最大的启发不是具体的技术实现,而是一种新的用 LLM 的思维方式。
大部分人现在用 LLM 还是把它当搜索引擎或者聊天机器人用,问一次答一次,答完就完了。
Karpathy 的思路是把 LLM 当成一个不知疲倦的知识工程师。
让它帮你把散乱的信息编译成结构化的知识网络,而且这个网络会随着使用不断增长。
每一次探索、每一次提问都在让你的知识库变得更好,这就是复利的力量。
09
都看到这了,关注下吧。
这个公众号历史发布过很多有趣的开源项目,如果你懒得翻文章一个个找,你直接关注微信公众号:逛逛 GitHub ,后台对话聊天就行了。
相关阅读和学习路线
如果你想继续沿着“AI Agent 教程”这个方向学习,可以先从下面这些站内内容建立路线,再回到本文判断具体资源是否适合自己。
📖 相关推荐

资深互联网从业者,专注AI工具研究与实战应用。长期跟踪ChatGPT、Claude、Stable Diffusion等前沿AI技术,擅长将复杂的技术概念转化为通俗易懂的教程。运营颜资源小站,致力于为中文用户提供高质量的AI教程、开源项目推荐和数字资源整理。
评论(0)