
英伟达把 33B 视频模型 MiniMax-H3 的推理优化开源了。
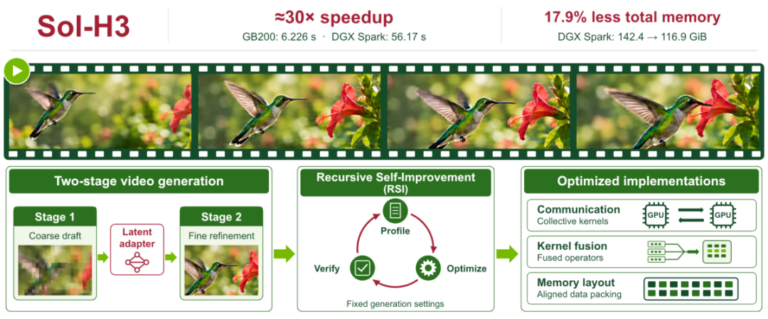
5 秒 1344×768 带立体声视频,8 卡 GB200 上 1.4 秒出片。单张 RTX 5090 也要 39.8 秒。
方案叫 Sol-H3,出自 NVlabs/Sana 仓库 sol-engine 分支,论文 9 月底挂出。
SECTION 0101 痛点:33B 视频模型,单卡根本跑不动
我最近在研究视频生成部署,绕不开 MiniMax-H3。它是 8 月初开源的 33B 全模态视频模型,一次生成带原生立体声的视频。
生态已经很热闹。ComfyUI 当天支持,社区量化、少步 LoRA 一堆。
问题也跟着来。33B 参数加 49 步去噪,单卡跑 5 秒 768p 要十几分钟。
云上按秒烧钱,本地根本装不下。
SECTION 0202 怎么压下来的:两阶段 + 潜空间直通
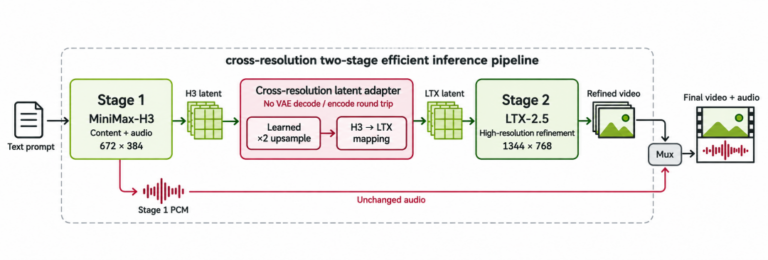
Sol-H3 的思路是把 49 步去噪换成两阶段。
Stage 1 在 672×384 小画布上跑 4 步,定下构图、运动、主音轨。
Stage 2 换 LTX-2.5,在全分辨率跑 3 步补高频细节。
49 次前向,变 7 次。
最巧的是那个 194M 参数的小适配器。
两个模型各用各的 VAE。常规做法是解码回像素再编码,一来一回 12.75 秒,比去噪本身还贵。
Sol-H3 训练一个适配器在潜空间之间直接翻译,耗时 63.1 毫秒,快 202 倍。
2.1 潜空间直通怎么做的
H3 的 VAE 是 24 通道、16 倍空间压缩。LTX-2.5 的 VAE 是 128 通道、32 倍压缩。
两组潜空间互不相通,时间对齐最难。H3 按 17 帧一块编码,LTX 用 8 倍因果网格。论文用”按物理帧位置对齐 + 无参数打包”绕过去。
效果:峰值显存从 13.79 GiB 降到 0.785 GiB。在 256 段测试视频上,与 LTX 解码结果 PSNR 达到 30.618dB。
2.2 剩下三层加速
通信。多卡并行时,基线每步要花 94 毫秒在布局转换和集合通信上。
RSI 把三次 QKV 交换合并成一次,纯布局改动,逐位一致。
传输还能再压一层。QKV 走块量化,输出按 132→144 字节对齐后,单条记录反而比不对齐更小格式传得快。
稀疏注意力。精修阶段 token 数暴涨,Sol-Attn 按 64-token 块打分,只算高分块。
三步精修分别取阈值 1.0、1.25、1.5。前两层永远全 dense。
安全栏:H3 把”文本|条件视频|音频|目标视频”打包成一条序列,前面整个前缀全部走精确注意力。音频链路一松,人声就崩。
显存瘦身。DGX Spark 和 RTX 5090 用的三板斧。
AdaLN 预计算省约 24GB,提示词缓存释放 16.2 GiB,量化用 FP8 H3 加 NVFP4 Qwen。
三招下来 142.4 GiB 压到 116.9 GiB,刚好塞进 119.68 GiB 的统一内存。
SECTION 0303 RSI 循环:AI 改内核,但戴着手铐
系统层那些脏活累活,它交给 RSI 循环。
它自动搜内核融合、内存布局、通信边界,跑分测延迟,再验证数值一致性,通过才收货。
论文给这个循环戴了副手铐,叫 fail-closed。
RSI 只能改”同一个生成契约的实现方式”,绝不能改契约本身。
步数不能少、分辨率不能动、数值轨迹不能偏。改完必须证明是同一起跑线上的纯提速,证明不了就丢弃。
3.1 反面教材:LoRA 合并为什么不行
把 LoRA 权重直接合并进基座,在 BF16 下 86.1%~94.4% 的非零权重更新会”四舍五入”回原值。
表面省了计算,实际数值轨迹已经变了。
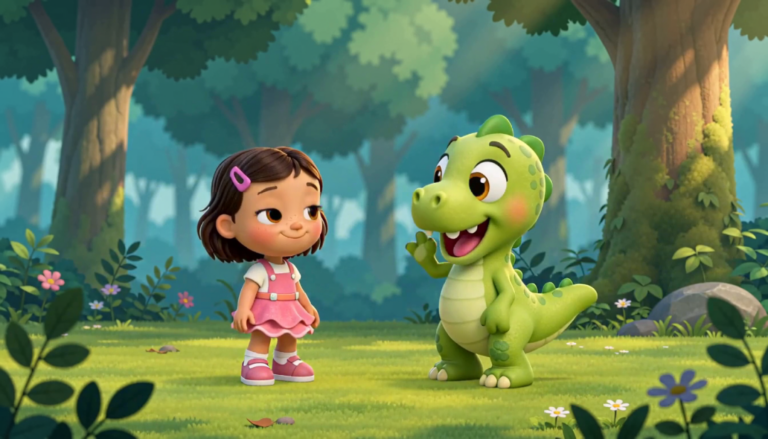
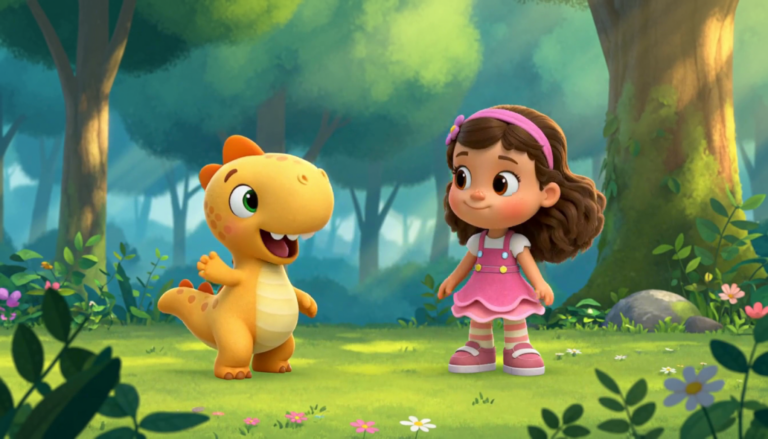
同样的提示词和种子,合并后画面里恐龙变橙黄色、女孩从直发变卷发。
3.2 替代方案:消费者融合
保留 LoRA 两条分支的三次矩阵乘,把加法揉进下游内核,保留每个 BF16 舍入点。
结果在测试输入上逐字节一致,还比原生分支快 0.694 秒。
把全文加速手段分成两本账,看任何数字先问一句”这是哪本账”:
| 账本 | 手段 | 代价 |
|---|---|---|
| 无损(不改输出) | 内核融合、布局合并、通信整合、LoRA 消费者融合 | 需要逐项数值验证 |
| 有损(换生成方式) | 49→7 步蒸馏、两阶段调度、稀疏注意力、量化传输、MXFP8、参考 KV 缓存 | 画质用评测兜底 |
SECTION 0404 各硬件档怎么跑
仓库按硬件铺了 5 条路线。
你按手里的卡对号入座:
| 硬件 | 路线 | 成绩 |
|---|---|---|
| 8 卡 B300/GB200 | Sol-H3 四步版 | 5 秒视频 1.653 秒 |
| 单张 RTX 5090 | 两阶段 + CPU 卸载 | 1344×768 成片 39.8 秒 |
| DGX Spark | 一体机整跑 | 热请求 56 秒 |
| 24GB 4090 | 原版 49 步卸载 | 约 8.4 分钟 |
| 8 卡 B200/B300 | 社区 HyperFlow 8 步 | 较原版再快 2.86-4.15 倍 |
所有路径都来自仓库文档,要求 Linux。
Windows 用户建议 WSL2。
SECTION 0505 数字好用,边界要看清
所有基准都是官方在特定配置下的自报数。
多卡延迟取五次热请求中位数,但每档任务只测一个提示词、一个种子。
RTX 5090 的 39.8 秒是单次正式请求,不是统计量。
有几处你要留心的取舍。
MXFP8 档画质损失明显,同种子 PSNR 13.82dB,能看出差别。
参考 KV 缓存是近似方案,适合参考素材很重的场景。
H3 权重走 MiniMax 社区协议,商用前务必读 LICENSE 原文。
这套方案深度绑定 NVIDIA 硬件栈。
从 cuDNN 稀疏后端到 SM100 专属的 MXFP8 路径,脱离 NVIDIA 卡复现不了。
画质成色,直接看对比。
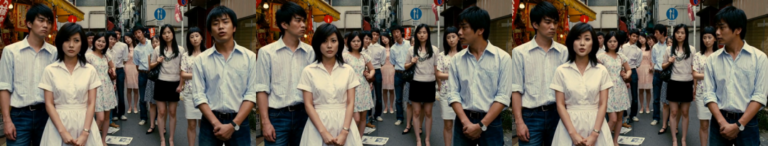
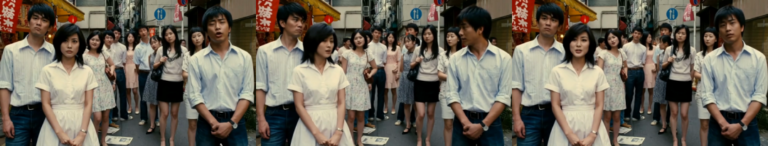
1344×768、5 秒,提示词”拥挤的日本街头,一男一女气氛紧张地交谈”。
49 步基线对比 Sol-H3:场景结构、人物身份、运动连续性保持,同一提示词下较基线提速 22.2 倍。
1080p 竹林武侠场景同样成立。高频细节正是 Stage 2 的活,相对基线 42.6 倍。
SECTION 06写在最后
英伟达值钱的地方,是示范了 AI 如何改自己内核。
改完能用数值验证,验证不了就丢弃。
视频部署的第二战场,从拼模型转向,拼谁部署得又快又便宜。
GitHub:https://github.com/NVlabs/Sana/tree/sol-engine/models/minimax_h3
📖 相关推荐

资深互联网从业者,专注AI工具研究与实战应用。长期跟踪ChatGPT、Claude、Stable Diffusion等前沿AI技术,擅长将复杂的技术概念转化为通俗易懂的教程。运营颜资源小站,致力于为中文用户提供高质量的AI教程、开源项目推荐和数字资源整理。
评论(0)