
全球 4B 参数规模以下开源基座模型的新榜首,居然是一个 2B 模型!
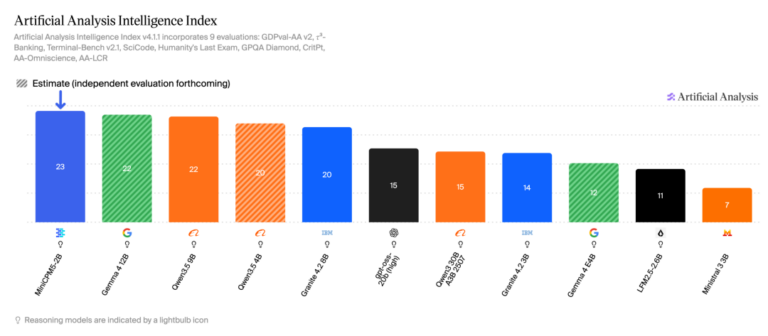
9 月 8 日,面壁智能与 OpenBMB 社区正式开源新一代端侧「小钢炮」——MiniCPM5-2B。在国际权威基准 Artificial Analysis Intelligence Index(AA 榜单)的最新评测中,MiniCPM5-2B 以 23 分的综合成绩登顶全球 4B 以下开源基座模型第一。
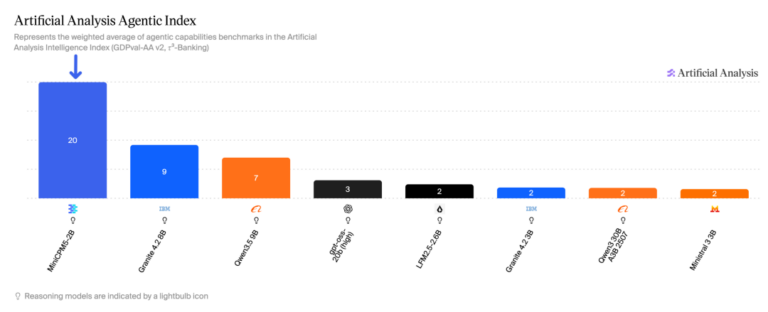
更引人注目的是其在智能体任务上的断层式领先:在专门评测 Agent 能力的 Agentic Index 指标上,MiniCPM5-2B 斩获 20 分。这一成绩不仅让同级 2B-4B 模型(普遍仅 2 分)难以望其项背,甚至超越了包括 Qwen3.5 9B、Gemma 4 12B 等参数量数倍于己的模型,展示出了端侧模型探索通用 Agent 的可能性。
与行业内普遍的模型仅开放权重不同,面壁智能与 OpenBMB 此次同步开源了 MiniCPM5-2B 背后的训练 Recipe(配方)、RL 框架及核心数据集,造福广大开发者!
AA 榜单 4B 以下性能第一,Agent 能力断层领先
按照 AA Index 最新榜单成绩,MiniCPM5-2B 是全球 4B 参数以下得分最高的开源模型(23分),高于参数量甚至数倍于己的 Gemma 4 12B(22分)、Qwen3.5 9B(22分)、Qwen3.5 4B(20分)。
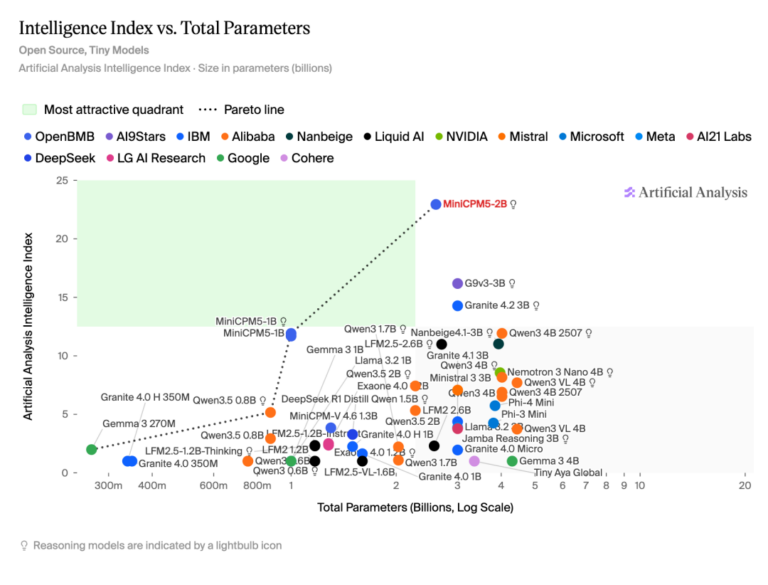
如果把所有模型按「参数量—得分」放进同一张坐标系,会看得更清楚:根据 AA 榜单,在 4B 参数规模之下,MiniCPM5-2B 站在整条帕累托线的最顶端,先前开源的 MiniCPM5-1B 版本也落在这条线上——两个尺寸,各自占住了同级别的性能天花板。
这正是面壁智能所坚持的「密度定律」最直观的印证:MiniCPM5-2B 以极高的单位参数智能密度,仅用约一半的参数体量(2B),就跑出了领先于 4B 模型的智能水平。
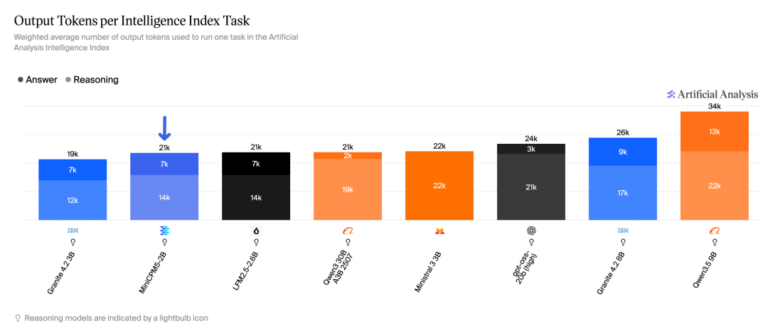
高分不是靠「堆 token 硬想」换来的。在完成同样的 Intelligence Index 任务时,MiniCPM5-2B 平均只消耗 21k 输出 token(其中推理 14k、回答 7k),处于全场最低一档——而得分相近的 Qwen3.5 9B 需要 34k,Granite 4.2 8B 需要 26k。对端侧部署来说,这意味着更快的响应和更低的推理成本。
本次评测覆盖通用知识、数学与代码推理、指令遵循、长文本、工具调用等任务。但比总榜名次更值得注意的是其 Agent 能力:在 AA Agentic Index 上,MiniCPM5-2B 拿下 20 分——不仅是第二名 Granite 4.2 8B(9 分)的两倍以上,更远超 gpt-oss-20b(3 分)等参数量十倍于己的模型;而多数同级端侧模型仅有 2 分,拉开明显差距。
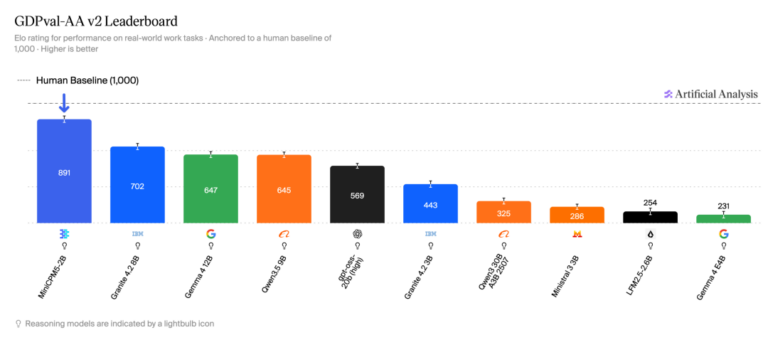
在衡量真实工作任务完成度的 GDPval-AA v2 榜单上(以人类基线 1000 分为锚点的 Elo 评分),MiniCPM5-2B 拿到 891 分,是所有参评模型中最接近人类水平的一个,领先第二名 Granite 4.2 8B(702 分)近 190 分,更把同尺寸模型(如:Granite 4.2 3B 325 分、Ministral 3 3B 286 分)远远甩在身后。
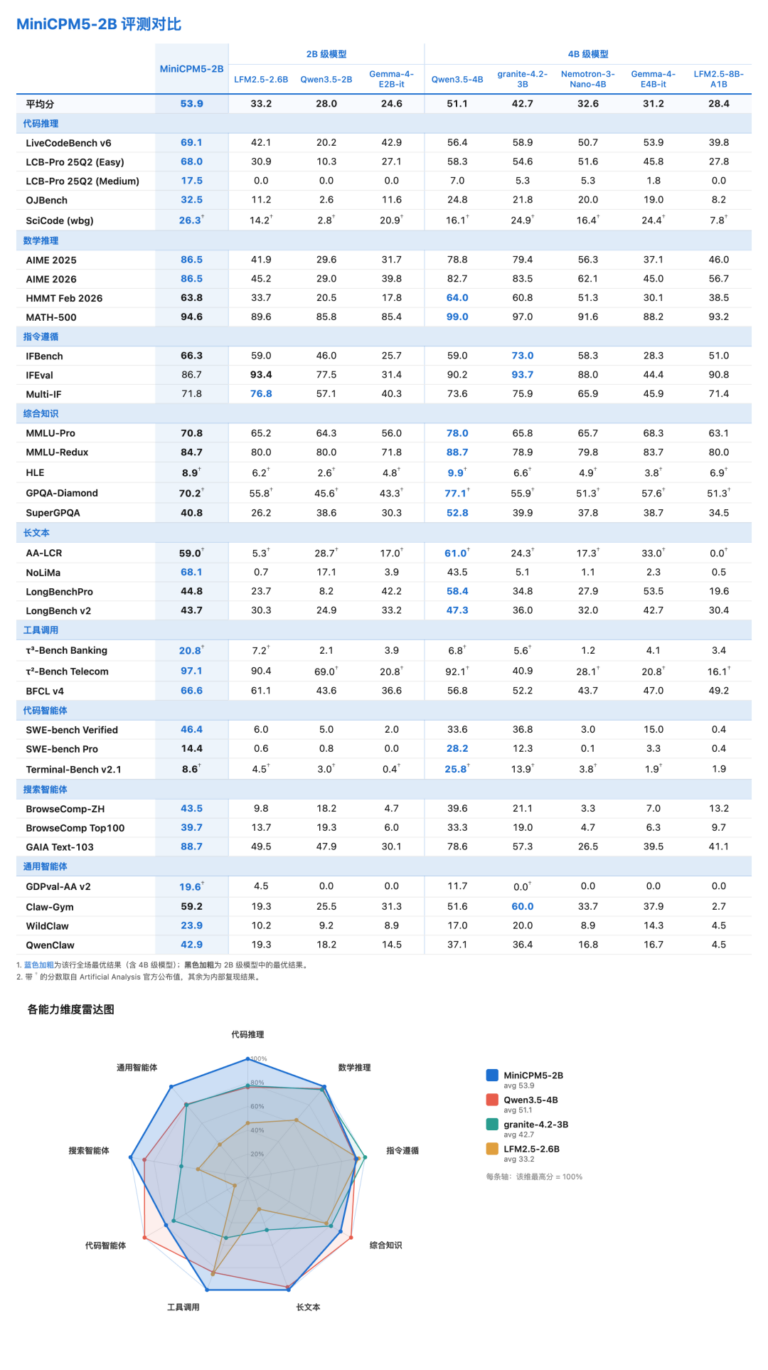
根据公开数据集的评测,MiniCPM5-2B 在「通用智能体 」、「搜索智能体 」、「工具调用」、「代码推理」等关键维度上均斩获最高分,用实际结果验证了通用 Agent 能力在高密度端侧模型上的技术可行性,为「端侧 Agent」打开了新的想象空间。
端侧 Agent 的落地价值,也正在变得更加清晰:
- • 隐私安全:在用户授权和操作系统权限机制允许的范围内,端侧 Agent 可以直接读取屏幕内容、调用本地应用,并处理设备上的本地数据——这些权限出于安全原因很难完全开放给云端服务。因此,「处理敏感重要信息」「实时感知用户状态」等体验可能会是端侧相对云端的能力增量。
- • 离线可用与确定性响应:端侧模型的核心推理不依赖网络连接和远程服务,因此可以减少网络波动、云端限流或服务故障带来的影响。对嵌入操作系统和硬件产品的 Agent(手机、车机、机器人),这种确定性比绝对速度更重要。
- • 成本优势:在硬件已经购置的前提下,本地推理通常不需要按照调用次数或 Token 数量持续支付云端 API 费用。对于常驻个人助理、每日自动化流程等长期高频 Agent 任务而言,端侧方案有望降低长期使用成本。
要知道,Agent 应用能否规模化,推理成本是其中一个重要约束,一个复杂 Agent 任务动辄消耗数十万 token。如果高密度端侧模型能承接相当一部分 Agent 工作任务,整个应用层的成本结构会发生实质性变化——这可能是 MiniCPM5-2B 最值得继续观察的行业价值。
在开源生态支持上,MiniCPM5-2B 延续了面壁智能一贯的开放性:微调侧已适配 LLaMA-Factory、ms-swift,推理侧覆盖 vLLM、SGLang、llama.cpp、Ollama 等主流框架,开发者在常规硬件上即可快速部署验证。截至2026年8月,MiniCPM 系列模型的开源下载量已突破 5000 万——社区用下载量投的票,往往比跑分更诚实。
那么问题来了:一个 2B 的模型,凭什么能够承载起复杂的 Agent 能力?
从数据治理到训练体系:高密度端侧模型是怎样炼成的
当参数规模受到端侧设备的硬约束时,底层的数据治理与训练技术栈就成为决定模型上限的关键变量。
在数据侧,这次与 MiniCPM5-2B 一同开源的四个数据集,将数据治理延伸到了训练流程的不同环节:
- • UltraX(预训练):用一个 0.6B 的小模型,对网页数据做「行级别」的自动编辑,避免了让大模型端到端改写整篇文本带来的语义漂移,原文的信息保真度更高,并且整个精修过程可审计、可追溯。用 UltraX 修复后的数据训练 1B 规模模型,160 亿 token 达到了原始数据训 200 亿 token 的效果。换算下来,同样的算力预算,数据处理得好,能「省」出 20% 的训练量。对于「寸 token 寸金」的预训练来说,这不是小数字。
- • UltraData-Code(代码预训练):按 L0–L3 分级治理,从 约 1.92 亿个 GitHub 仓库逐级精炼,完成 L1 清洗去重、L2 算法代码筛选(约 400B Token)和 L3 任务导向的结构化合成(约 150B Token),将真实代码转化为任务、推理、实现与测试对齐的高质量训练样本;
- • UltraData-SFT-Agent-2609(SFT):包含 50 多万条 Agent 训练样本,覆盖从基础工具调用到长链路复杂工作流等多样化的任务,为端侧 Agent 模型提供全链路训练信号;
- • UltraData-RL-2609(RL后训练):针对答案不可验证、奖励标签不可信、难度不匹配三大痛点,设计了「可验证性过滤→多模型共识校验→rollout 难度筛选」的三阶段清洗流水线,为强化学习提供高信噪比的奖励信号。
在训练框架侧,面壁智能随 MiniCPM5-2B 一同开源了全新的自研强化学习框架 Meshy。Meshy 彻底去掉了 RL 训练的中央控制器和 Ray 依赖,将训练、推理、奖励计算等全部建模到对等服务,利用 TransferQueue 中的数据就绪状态来驱动实际控制流,能够简单的在同步、异步、全异步三种训练模式中灵活切换,便于扩展。
在算法层面,端侧模型做长思维链强化学习,常常训练过程中分数不升反降:一方面训练数据里噪声多、难度不匹配,奖励信号容易带偏模型;另一方面 GRPO 信用分配太粗糙,面对上万词元的推理链,分不清哪步对、哪步错。为此,MiniCPM 团队提出基于奖励的强化学习策略 JustRL II:数据上,用三阶段流水线筛选校准训练数据;算法上,给 GRPO 装上 Critic,实现词元级信用分配。在 JustRL II 加持下,MiniCPM5-2B 在 RL 后训练中获得了显著的性能收益。
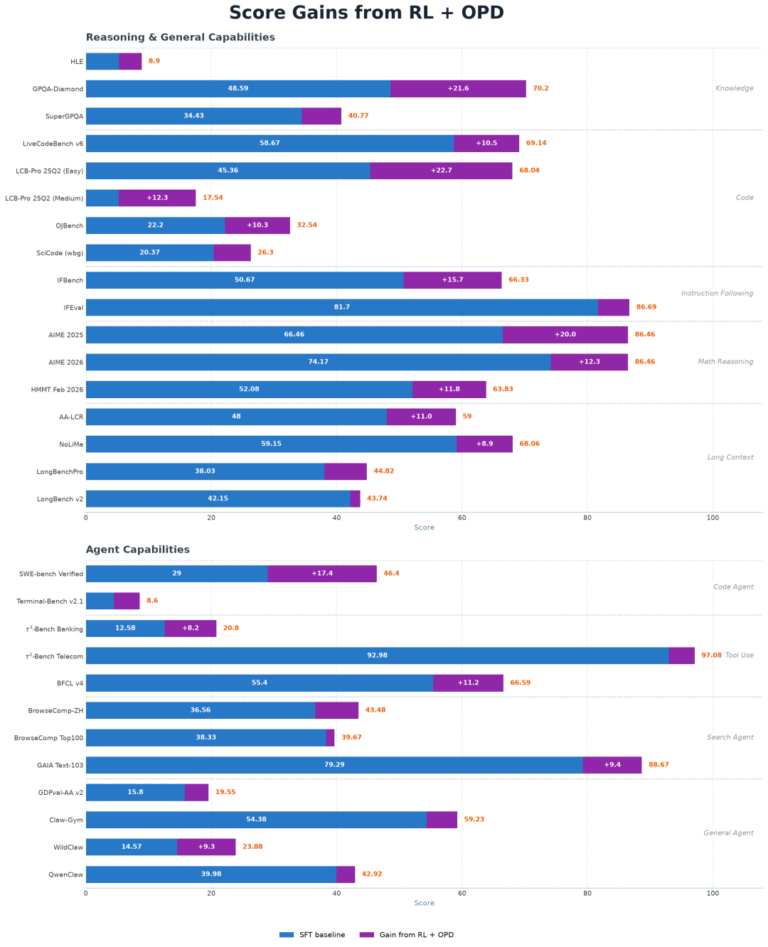
从行级精修的数据管线,到底层自研的轻量框架与信用分配算法,这些技术最终转化成了 MiniCPM5-2B 的智能密度。
同样值得关注的是面壁智能在开源生态层面的选择:面壁智能并未将这些筑起性能壁垒的核心资产留作私产,而是将模型权重 + 训练 Recipe + 四个训练数据集一并开源了。
熟悉开源大模型生态的人应该能看出这份清单的分量,这在头部大模型团队里是绝对罕见的做法。面对行业普遍将数据视为「绝对黑箱」的现状,不妨来算一算面壁智能这本不同寻常的「开源账」。
一本开源账:十个数据集,三年时间线
行业里有个心照不宣的共识:数据管线是各家真正的护城河。
厂商不公开数据的理由也不难理解:模型架构写进论文,半年内就会被全行业消化;真正留得住的差距在数据管线——数据从哪来、怎么筛、怎么配比、怎么合成等等。所以如果较真去看,绝大多数所谓的「开源模型」,开的其实只是权重。
开放源代码促进会(OSI)在 2024 年发布「开源 AI 定义」(OSAID)时,就曾因为「是否必须公开训练数据」引发过一轮激烈争论——按照严格标准,市面上能称得上「开源 AI」的大模型寥寥无几。「open weights」(开放权重)这个更精确的说法在学界越来越通行,某种程度上就是对现状的一种妥协性描述。
这种现状的后果由社区承担——数据黑箱意味着可复现性差:你可以微调一个开源模型,但你无法验证它为什么是这个水平、无法在它的基础上做真正的训练侧研究。
正因为如此,面壁智能这次 MiniCPM5-2B 的开源动作才更加值得关注。单看一次发布,你可以说这是营销策略。但把时间线拉长看,会发现这件事对面壁智能来说更像是惯性动作。
从 2023 年底至今,面壁智能和它背后的 OpenBMB 开源社区,累计开源了超过 10 个大模型训练数据集,覆盖网页语料、数学、代码、对话、偏好对齐等几乎所有训练环节:
2023 年 4 月,UltraChat。 约 150 万条合成多轮对话,至今已被全球超过 200 个大模型用于对齐训练,月均下载量破百万,成为开源微调领域引用最广的数据基座之一。
2023 年 12 月,UltraFeedback。 6.4 万条提示词、38 万条 GPT-4 反馈的偏好数据集,可用于训练奖励模型。基于它训练的 UltraRM 曾刷新开源奖励模型的 SOTA,Zephyr-7B 等社区明星模型的对齐训练均采用了该数据集。
2025 年 12 月,Ultra-FineWeb。 约 1T 英文 + 120B 中文 token 的高质量网页预训练语料,开源后登上过 Hugging Face 热门榜第一。
2026 年,节奏明显加快。 2 月的 UltraData-Math(290B+ token 的分级数学语料)、5 月的 Ultra-FineWeb-L3(600B token,其中中文 200B+,是目前开源社区规模最大的中文预训练合成数据集之一)、7 月的 UltraX-Preview、8 月的 Ultra-FineWeb-L1,几乎「按月上新」。
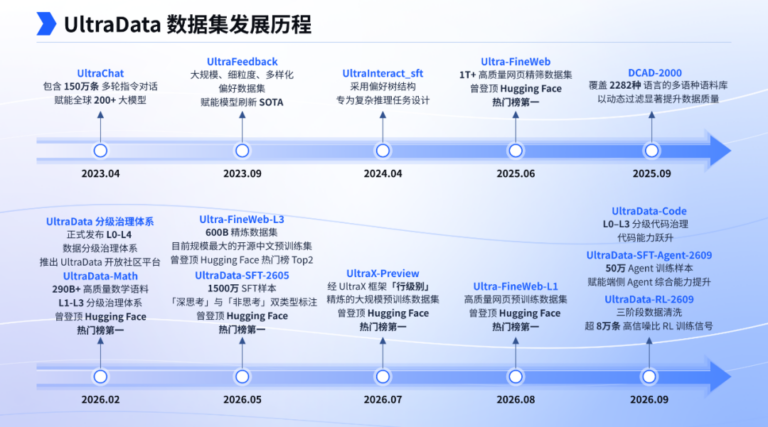
截至 2026 年 9 月,UltraData 系列数据集的开源总下载量超过 266 万次。
这条时间线说明两件事。第一,开源数据不是一次性的发布动作,而是面壁智能及 OpenBMB 社区一以贯之的长期贡献。第二,开源的数据绝非边角料,而是实打实进入了全球主流模型训练管线、被反复验证过的高价值资产,不是「开了但没人用」的姿态性开源。
模型跑分是台前的热闹,数据是幕后的苦工。这种「授人以渔」的开源方式,正在实质性地降低社区内研究端侧大模型的门槛,为广大开发者提供了极具研究和复现价值的基石。
通往 AGI 的路上,高质量数据是最厚的地基
数据的功夫做在暗处,但它的回报写在明处——而且不止写在一款模型上。把这次 MiniCPM5-2B 开源放进行业坐标系里看,它回应的其实是一个更大的问题:当算力红利见顶,模型能力的增量从哪里来?
过去几年,提升模型能力最直接的路径是堆参数、堆算力,但这条路的边际收益在肉眼可见地递减——参数翻倍带来的提升越来越小,成本却照旧翻倍。当「更大」不再自动等于「更好」,各家比拼的重心就在向数据侧转移。数据治理正在从不见光的后台工作,变成决定成败的核心竞争力。MiniCPM5-2B 综合性能登顶全球同级模型,本身就是这个判断的一个证明。
从长期看,开源训练数据以及数据治理的工具和方法,可能比开源模型本身对行业的持续影响更大。一个模型的先进性是有保质期的,几个月后就会被新模型盖过;但一套公开的修复方法、一个人人可用的 0.6B 修复工具、一批高质量的数据集,是别人可以接着往上盖的地基。
模型开源给行业的是一件成品,数据治理开源给行业的是造成品的能力——后者的复利,要用更长的时间尺度才能看清。
MiniCPM5-2B 开源链接 (含模型与 UltraData 系列数据):
- • Hugging Face:https://huggingface.co/collections/openbmb/minicpm5
- • GitHub:https://github.com/OpenBMB/MiniCPM
Meshy 框架开源链接:
- • GitHub:https://github.com/OpenBMB/Meshy
- • 博客:https://maydomain.notion.site/meshy-blog-zh
JustRL II 强化学习算法:
- • 博客:https://panhaoxuan.notion.site/justrl-ii-small-llms-to-128k-reasoning-with-a-critic-cn

如果本文对您有帮助,也请帮忙点个 赞👍 + 在看 哈!❤️
在看你就赞赞我!
📖 相关推荐

资深互联网从业者,专注AI工具研究与实战应用。长期跟踪ChatGPT、Claude、Stable Diffusion等前沿AI技术,擅长将复杂的技术概念转化为通俗易懂的教程。运营颜资源小站,致力于为中文用户提供高质量的AI教程、开源项目推荐和数字资源整理。
评论(0)