
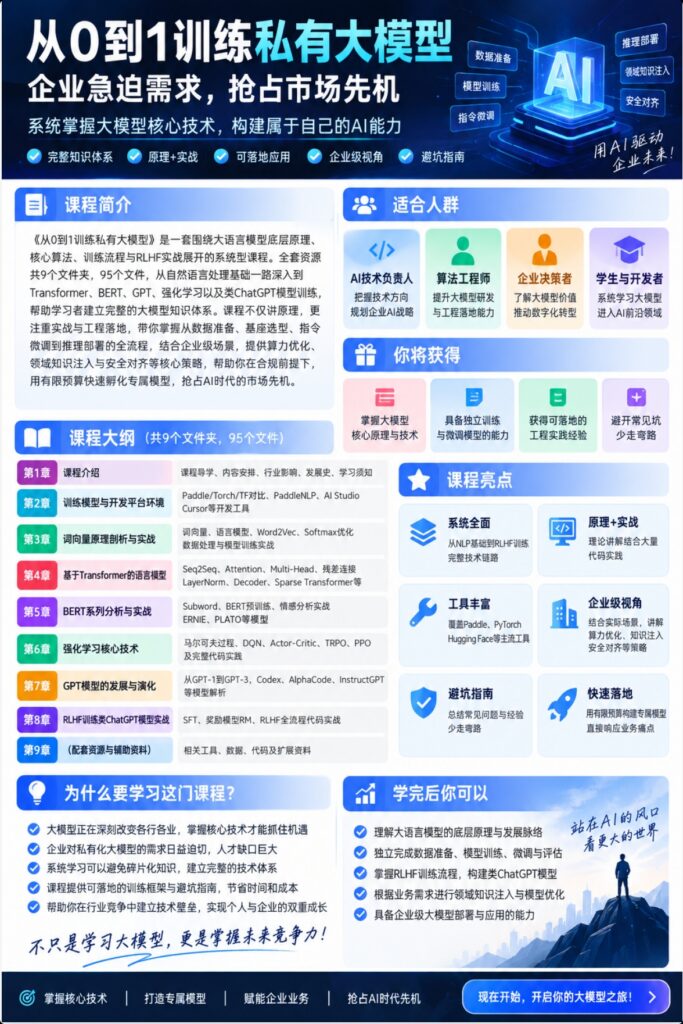
《从0到1训练私有大模型——企业急迫需求,抢占市场先机》是一套围绕大语言模型底层原理、核心算法、训练流程与RLHF实战展开的系统型课程。整套资源共包含9个文件夹、95个文件,从自然语言处理基础一路深入到Transformer、BERT、GPT、强化学习以及类ChatGPT模型训练,帮助学习者建立一套较完整的大模型知识体系。课程并非只停留在调用现成API或简单使用AI工具,而是从模型为什么能够理解文字、如何完成预训练、如何进行指令训练,以及如何借助人类反馈优化模型行为等关键问题入手,逐步拆解大模型背后的技术逻辑,适合希望真正理解大模型训练机制、提升算法与工程能力的学习者。
课程前期首先从开发环境与技术框架入手,对Paddle、PyTorch、TensorFlow等主流深度学习框架进行对比,并介绍PaddleNLP、Hugging Face、AI Studio以及Cursor等工具,为后续模型开发建立基础环境。随后进入自然语言处理核心知识,包括语言模型、PPL评估指标、Word2Vec、CBOW、Skip-Gram、Softmax优化、负采样、激活函数以及RNN、LSTM、ELMo等内容,并通过数据准备、文本预处理和模型训练案例,让学习者理解文字如何被转化为向量,以及神经网络如何从文本数据中学习语义关系。这一部分能够帮助学习者补齐大模型学习过程中容易忽略的NLP基础,避免只会套用框架却不理解底层原理。
课程中段重点讲解Transformer与BERT体系。从Seq2Seq、Attention机制开始,逐步深入Multi-Head Attention、多头注意力、残差连接、LayerNorm、Decoder、Sparse Transformer以及Transformer-XL等核心结构,并针对长序列建模、梯度稳定性和模型训练效率等问题进行分析。在BERT部分,则进一步覆盖Subword、BPE、WordPiece、NLP常见任务、BERT预训练机制、情感分析实战、模型评估与预测,并延伸到ERNIE、PLATO等模型,使学习者能够从不同技术路线理解现代预训练语言模型的发展过程,而不是单纯停留在GPT一家模型体系之中。
后半部分进入课程的重要进阶内容——强化学习与GPT技术演化。课程系统讲解马尔可夫过程、DQN、Double DQN、Dueling DQN、REINFORCE、Actor-Critic、TRPO与PPO等算法,并结合PyTorch进行代码实践,为理解RLHF打下基础。同时从GPT-1、GPT-2、GPT-3一路讲到Codex、AlphaCode、InstructGPT等模型,让学习者理解大语言模型从预训练、任务适配到指令对齐的发展路线,以及为什么现代对话模型能够从“生成文本”进一步进化到“理解并遵循人类指令”。
最后一章是整套课程最具实战价值的部分,围绕类ChatGPT模型训练流程进行完整拆解,包括SFT有监督微调、数据处理、Trainer训练流程、奖励模型RM训练,以及RLHF中的Dataset、Model、Generation、Experience Maker、Buffer、Loss和Main训练流程等关键模块。通过这一部分,学习者可以把前面分散的Transformer、GPT与强化学习知识真正串联起来,理解“基座模型+监督微调+奖励模型+强化学习优化”的完整技术链路。整体来看,这套课程特别适合Python及深度学习开发者、NLP算法工程师、AI方向学生以及希望系统进入大模型领域的技术人员,可用于建立大模型底层知识框架、理解RLHF训练机制,并为后续学习LoRA微调、RAG、Agent、模型私有化部署及企业级AI应用打下扎实基础。
📖 相关推荐

资深互联网从业者,专注AI工具研究与实战应用。长期跟踪ChatGPT、Claude、Stable Diffusion等前沿AI技术,擅长将复杂的技术概念转化为通俗易懂的教程。运营颜资源小站,致力于为中文用户提供高质量的AI教程、开源项目推荐和数字资源整理。
评论(0)