
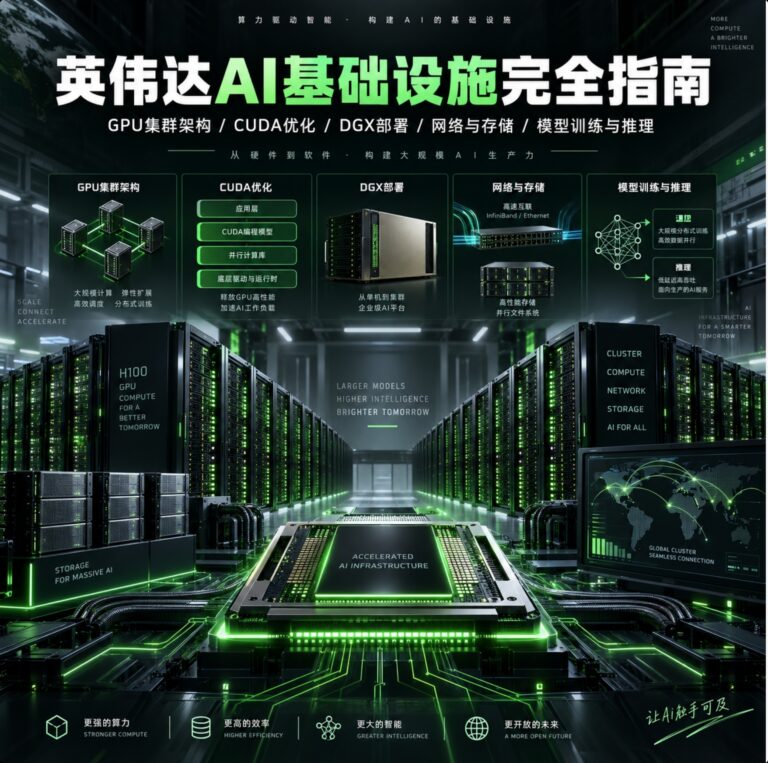
《英伟达AI基础设施完全指南》是一套围绕 NVIDIA GPU 加速计算、AI 数据中心建设与大规模人工智能基础设施部署打造的系统化实战课程。课程从人工智能行业发展背景与核心概念切入,逐步延伸至 GPU 架构、数据中心网络、分布式通信、存储系统、虚拟化、CUDA 软件生态、DGX 超算平台以及 AI 集群调度等关键技术,帮助学习者建立一套从单机算力到大规模智算中心的完整知识体系。对于希望深入了解 AI 基础设施、GPU 集群以及企业级大模型算力平台的技术人员而言,这套课程能够提供较为完整的学习路线。
课程前半部分首先梳理人工智能发展的核心驱动力、主要行业应用以及 Transformer 等基础模型架构,让学习者理解为什么当前大模型训练会对计算、网络、存储和能源提出如此高的要求。随后进入 AI 数据中心专题,讲解数据中心整体架构、PUE 能耗指标、CPU 与 GPU 的差异以及 GPU 架构演进过程,从宏观层面建立“算力基础设施”的整体认知。通过 CPU 与 GPU 高层架构对比、GPU 核心组件与核心架构解析,可以进一步理解 GPU 为什么能够在深度学习、科学计算以及大规模并行任务中获得远高于传统 CPU 的计算效率。
在硬件平台方面,课程重点解析 NVIDIA RTX 系列 GPU、DGX 系统、DGX 平台以及 DGX SuperPOD 等核心产品与架构,并对 DGX A100 与 H100 等不同代际平台进行比较,帮助学习者理解不同 GPU 架构在算力、显存、互联以及AI训练能力方面的区别。同时还会介绍 NVIDIA BlueField DPU、GPU 虚拟化、vGPU 与 MIG 等企业级技术,使学习者能够理解如何在数据中心环境中完成 GPU 资源隔离、共享和统一管理,为多用户、多任务以及云端 GPU 平台建设提供技术基础。
网络与存储是大规模 GPU 集群中极其重要的一环。本课程专门讲解 AI 数据中心常见的四种网络结构,并对以太网、InfiniBand、融合以太网等方案进行对比,同时深入解析 RDMA、高性能 GPU 通信以及 NVIDIA GPU Direct 技术。通过 GPU Direct RDMA、GPU Direct Storage(GDS)等内容,学习者能够理解如何减少 CPU 中转和数据复制,让 GPU、网卡和存储设备之间实现更加直接、高效的数据传输,从而解决多卡训练中经常出现的通信瓶颈和存储吞吐问题。
在软件与并行计算部分,课程进一步深入 NVIDIA CUDA 技术栈,讲解 CUDA 如何释放 GPU 并行计算能力,并结合 NCCL 深入分析多 GPU、多节点之间的高速通信机制。这部分内容对于理解大模型分布式训练尤为重要,因为随着模型规模不断扩大,单张 GPU 已经难以独立完成训练任务,必须依赖数据并行、模型并行以及跨节点通信技术实现算力扩展。课程通过 NVIDIA NCCL、高性能 GPU 通信和相关技术栈的梳理,帮助学习者掌握现代 AI 集群背后的核心运行逻辑。
除此之外,课程还覆盖深度学习框架、AI 模型训练与推理之间的区别、人工智能工作流以及 NVIDIA 垂直行业解决方案,并进一步讲解 Slurm 与 Kubernetes 两种主流集群调度方案。学习者不仅可以了解传统 HPC 环境如何通过 Slurm 管理 GPU 计算资源,也可以理解云原生环境下 Kubernetes 如何支撑容器化 AI 训练和推理任务,从而建立从硬件资源、网络互联、软件框架到集群管理的完整认知。
整体而言,《英伟达AI基础设施完全指南》并不是一套只介绍显卡参数或 CUDA 编程的单点课程,而是一套面向现代 AI 数据中心和大模型算力平台的综合型基础设施教程。它将 GPU、DGX、BlueField、InfiniBand、RDMA、GPU Direct、CUDA、NCCL、存储、虚拟化以及集群调度等知识串联起来,让学习者真正理解一套高性能 AI 平台是如何从硬件到软件逐层构建起来的。无论你是 AI 工程师、云计算与数据中心工程师、GPU 集群运维人员、平台架构师,还是正在规划企业智算中心和大模型训练平台的技术负责人,都可以通过这套课程系统提升对 NVIDIA AI 基础设施的理解,为后续搭建、部署和优化大规模 GPU 计算平台打下扎实基础。
📖 相关推荐

资深互联网从业者,专注AI工具研究与实战应用。长期跟踪ChatGPT、Claude、Stable Diffusion等前沿AI技术,擅长将复杂的技术概念转化为通俗易懂的教程。运营颜资源小站,致力于为中文用户提供高质量的AI教程、开源项目推荐和数字资源整理。
评论(0)