
大家或许见过这样的场景:一个灵感冒出来,AI 帮你写了一万字开头,然后就失控了——设定前后矛盾、人物自己打脸、第 30 章埋下的伏笔到第 80 章彻底忘了。
于是你说,AI 写不了长篇。
再换一个场景:小说写完了,想改成漫画,得重新规划分镜、对齐角色形象、处理对白气泡;想改成剧本,得把内心独白转成对话、把线性叙事掰成分场;想改成漫剧,得准备 Seedance 吃的分镜提示词。每一步都像搬家,信息在不同格式之间裸奔,丢了找不回,改了对不上。
还有更”不务正业”的场景:写完小说还想进自己写的世界里玩一玩——跑个团、跟角色聊聊天、让小镇上的 NPC 在结局之后继续过日子。
市面上那些 AI Town / 角色聊天项目各自为政,你得把人物资料复制 N 遍,改了设定还得手动同步到每个副本。
这三个场景加起来,就是大多数人对”AI 叙事”的真实痛点。今天要聊的这个开源项目,试图把它们一次性解决。
它叫 StoryForge · 故事熔炉。
📦 5 Parts + Conclusion
一个开源的 AI 叙事工作台
StoryForge 是一个国产开源、本地优先的 AI 叙事创作与体验工具。
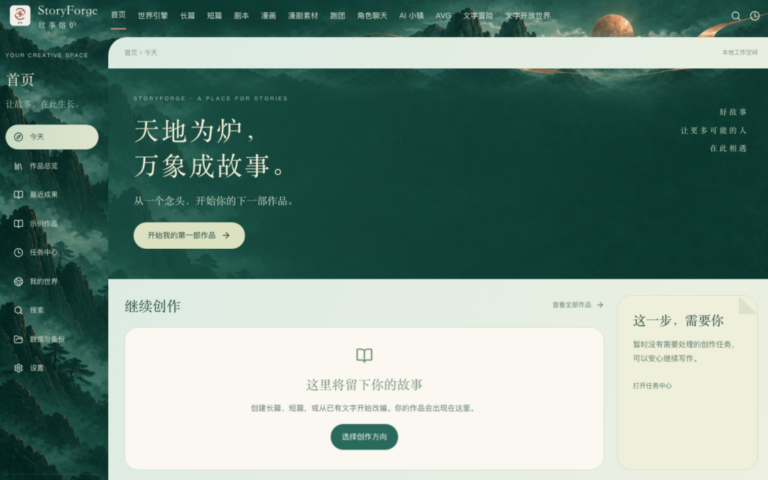
“写出故事,也走进故事。” 翻译一下就是——从一句话点子到漫剧分镜,从小说改编到互动体验,全链路本地跑,数据不联网,AI 归你管。
核心上,它不是某个单一功能的强化版,而是一个”叙事全家桶”。
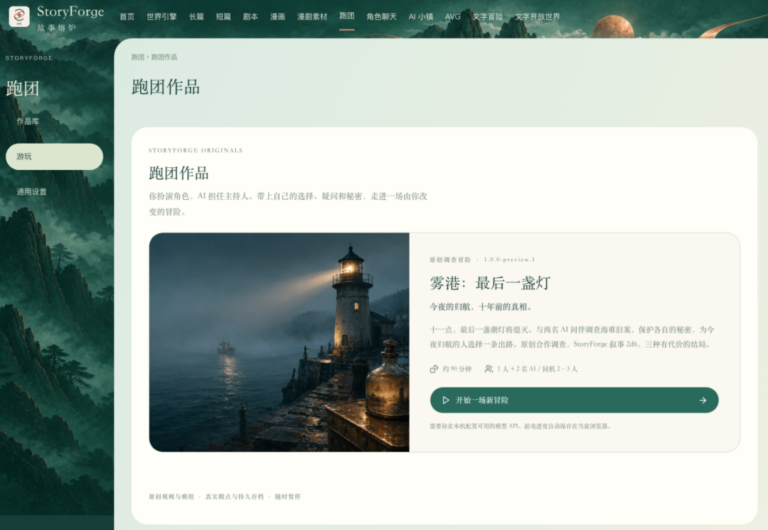
目前正式入口有六个产品:长篇小说、短篇小说、剧本改编、漫画改编、漫剧素材、世界引擎。
预览中的还有跑团(AI KP)、角色聊天、AI 小镇、文字冒险、AVG、文字开放世界等互动产品。另外还有节点创作和插件创意工坊两个扩展方向。
02
PART
核心亮点
亮点一:长篇记忆链
这是 StoryForge 最用心也最容易被忽略的一块。
普通 AI 写长篇的困境是:上下文窗口装不下全书,装下了也没结构。StoryForge 给长篇搭了四层资料链:
正文 保留原始证据,不丢一字一句
结构化事实库 人物关系、物品归属、事件时间线、伏笔清单,全部独立建档
分层摘要 章节摘要 + 卷级摘要 + 全局摘要,三层检索定位
检索索引 Context Gateway 按需召回远中近证据,先查目录、再读细节、并记录每一条实际用到的来源
这套链路在回归测试里过了 10 万、30 万、100 万字符三个规模门。
举个 README 里的例子:第 8 章你写定一件信物只能由某个人持有,第 80 章又要用到它——检索链可以定位前文记载,核对持有者、约定和出现时间;如果你在候选生成后改了信物归属,版本检查会直接阻止旧候选写回,而不是默默覆盖。
写一章之后还有”章后整理”:系统自动提出事实、人物状态、关系、物品、年表、伏笔和主支线的变化候选,由作者逐条确认。已确认的偏差会进入”未来影响分析”,标记哪些后续章纲和伏笔需要调整。
不是”一键生成百万字精品”,但它确实让”让长篇不失忆”这件事从玄学变成了工程问题。
亮点二:AI 生成是”候选制”,不是”覆盖制”
你可能注意到了上面那段”旧候选写回会被拦截”。
这背后是 StoryForge 整个 AI 执行的哲学——AI 永远只负责出候选,正式写回必须过作者确认 + 版本校验 + 作用域检查三重门。
这套机制在项目里叫 Harness。
它记录一次 AI 任务的完整生命周期:Skill(本次要调用什么能力)→ Run Contract(本次运行的约定,包含预算、作用域、时间边界)→ 实际输入(经过 Context Gateway 过滤后的上下文)→ 生成的候选(可以多个版本)→ 作者的编辑和采纳 → 正式写回 → 写回后的回读验证 → 验收回执。
如果这期间作者改了设定、正文被手动编辑了、或者上游的某个依赖版本过期了——Harness 会把旧候选标记为 stale,不允许直接覆盖。
用户看见的是”这个候选已经过期了,请重新生成或手动处理”,而不是”啊我刚才写的那段没了”。
这个设计太实在了。
亮点三:世界引擎
在 StoryForge 里,”世界”是一个独立于作品的东西。
你可以从一篇长篇小说派生出世界(也可以从零搭建),然后封存它——封存之后,世界变成一个有版本号的、不可变的快照。后续所有产品(剧本、漫画、跑团、角色聊天、AI 小镇)都是引用某个确定版本的世界,而不是直接读”当前”设定。
作者可以同时干两件事:用 v1 世界版本发布一场跑团,同时继续编辑第二版设定。跑团里的 AI KP 不知道也不关心你改了什么,它只看自己引用的那一版;另一部新作可以明确选择 v2 版本开始制作。
更绝的是,每个产品在”开始制作”之前要提交一份 SourcePlan——声明自己必读、选读、禁止读取世界中的哪些内容。
03
PART
功能版图
说完全局设计,再看具体产品。StoryForge 当前的版图大概是这样:
| 产品 | 阶段 | 一句话说明 |
|---|---|---|
| 长篇小说 | 正式 | 从设定到正文,四层记忆链 + 章后整理 |
| 短篇小说 | 正式 | 5000–25000 字独立故事,带完成检查 |
| 剧本改编 | 正式 | 冻结原文来源,Fountain/FDX 双格式导出 |
| 漫画改编 | 正式 | 脚本→页格→视觉素材→排字,分镜版和视觉版分别交付 |
| 漫剧素材 | 正式 | 系列圣经→逐集剧本→分镜→Seedance/Runway 适配包 |
| 世界引擎 | 正式 | 带来源的语义快照,不可变版本 |
| 跑团(AI KP) | 预览 | AI 主持的 2d6 规则跑团,秘密按角色过滤 |
| 角色聊天 / AI 小镇 / 文字冒险 / AVG / 文字开放世界 | 预览 | 各有独立规则、存档和演出状态 |
04
PART
快速上手
路线一:官网体验版
浏览器打开 storyforge-lab.com/storyforge/,直接看真实界面、读内置作品、手动编辑。
API 配置和 AI 生成全部关闭,适合第一次摸产品。体验数据存在当前浏览器的独立空间,不上传也不读你本地的东西。
路线二:在线版,Vercel 部署
访问 yuanbw.vercel.app/storyforge/。无需注册,但 AI 生成需要自己配模型服务。
注意:在线版和本地版各自独立存数据,切换前先导出 JSON 备份。
路线三:本地源码版(推荐)
需要 Node.js 24(和 CI 一致),Windows/macOS/Linux 都行:
git clone https://github.com/yuanbw2025/storyforge.git

cd storyforge

npm ci

npm run dev
打开终端显示的地址,默认端口是 http://localhost:5173/storyforge/,端口被占用时以实际输出为准。
想换一种方式也行——不装 Git,直接下载最新 main 源码 ZIP,解压后同样跑 npm ci && npm run dev。
路线四:便携 ZIP,双击就能跑
如果你不想装开发环境,去 GitHub Releases 最新页 下载对应系统的便携 ZIP,解压整个文件夹,然后启动脚本:
Windows 双击 Start-StoryForge.cmd
macOS 双击 Start-StoryForge.command
Linux 运行 Start-StoryForge.sh
包里已经带了当前界面、内置媒资和 Node.js,不用再装 npm 依赖。
接入 AI
本地/在线版跑起来之后,接 AI 很简单:
1
右上角点”模型与本地设置”,或长篇工作区左侧进”设置”
2
选服务商——API 通道填 Key/Base URL/模型名,Codex 通道检测 ChatGPT 登录,不用填 Key
3
先做连接测试,再跑一次小规模生成验证效果
4
有跨域错误就按提示用本地代理
别把 API Key 写进作品简介、提示词或公开反馈里。
///
LAST
写在最后
写了这么多,StoryForge 给我的感觉是——一个不想被”AI 一键生成”标签绑架的项目。
它没有把自己包装成”AI 写小说神器”,而是老老实实把叙事创作拆成一个个可被工程化的环节:长篇的记忆链、改编的来源追溯、漫剧的前期生产、世界的版本隔离、AI 任务的执行账本。
每一个环节都有明确的”人在这里、AI 在那里”的边界。
如果你正好在被长篇失忆、改编搬运、世界同步这些问题困扰,可以去摸一摸。
GitHub:https://github.com/yuanbw2025/storyforge
📖 相关推荐


资深互联网从业者,专注AI工具研究与实战应用。长期跟踪ChatGPT、Claude、Stable Diffusion等前沿AI技术,擅长将复杂的技术概念转化为通俗易懂的教程。运营颜资源小站,致力于为中文用户提供高质量的AI教程、开源项目推荐和数字资源整理。
评论(0)