
拉片是视频创作者的基本功——
看一条片子,逐镜头拆解:时长多少、景是什么、运镜怎么动的。
但手动拉片太费时了。你盯着一条 5 分钟的片子,花 2 小时记笔记。
GitHub 上一个项目把这个活全自动化了:两个 skill,零 API 成本,把拉片+分镜合成一条龙搞定。
01 两个 skill,各干各的
reelbench-skills 拆成两个独立 skill:
video-shots:拉片。把一条成片拆成逐镜头的分析表——时长、景别、类别、运镜、画面描述、节奏分析。
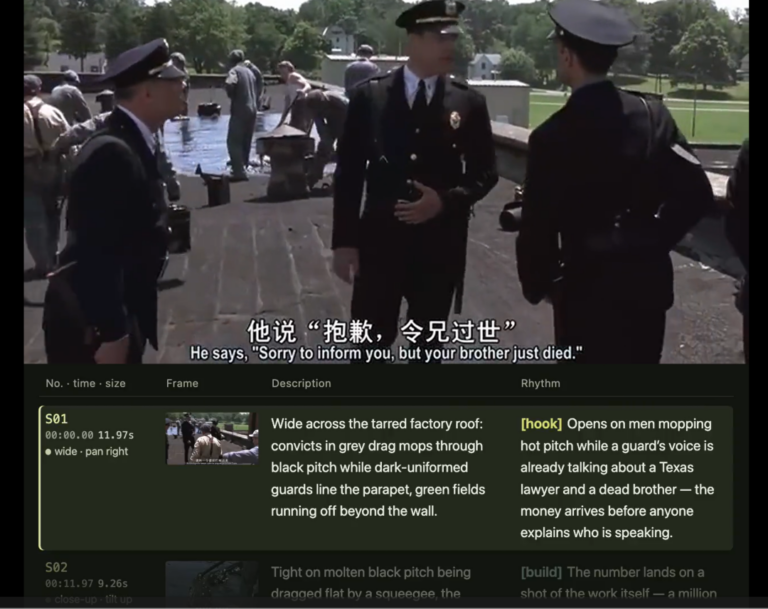
video-sync:分镜合成。把拉片数据和原片合成一条新视频,画面一边、分镜信息一边,镜头切了信息跟着切,列表自动滚动高亮。
安装极简,没 npm 依赖,没 API Key,Linux 装好 ffmpeg 就行。
02 镜头边界是量出来的,不是看出来的
这个 skill 的设计哲学很硬:代码能干的绝不丢给模型。
模型最不可靠的就是报时间。
你让它判断景别、运镜、画面内容、节奏——这些是模型的活。
但切点在哪、每镜多长、帧间运动量多大——这些全是代码干。
流程分三步:
第一步,ffmpeg 场景检测出切点,相减得时长,逐帧差分算实测运动量。
第二步,模型只负责填镜头表里的定性字段——景别、类别、运镜、画面描述、节奏分析。
第三步,15 道质量门逐条对账,错的当场拦下。
03 15 道质量门,全是代码
quality gate 是硬规则。每道门都有击穿用例证明它真的会拦。
| 门 | 规则 |
|---|---|
| 时间轴连续 | 按时间排序、首尾相接、从 0 开始、收在片尾 |
| 时长自洽 | seconds = end − start;短于 0.3 秒的必须在 note 里说明 |
| 镜号纪律 | S01 起、两位补零、连号 |
| 景别/类别/运镜 | 三张词表逐个对账,空着不填也拦 |
| 画面描述可核对 | 够长(中文 ≥12 字)+ 不许写空话词表 + 不许以”这个镜头…”开头 |
| 画面描述不重复 | 两镜一字不差 = 没看第二眼 |
| 类别要有证据 | 对话必须有台词、字卡必须有画面文字、空镜里不许有人 |
| 运镜实测对账 | 声称大幅运镜却实测几乎不动 → 拦 |
| 边界来自检测 | 每个边界要么来自自动检测,要么手动声明 |
| 关键帧齐全 | 报告要嵌图,缺图明说缺,不猜不骗 |
449 项断言全部通过,自测脚本跑一遍就知道门有没有效。
04 报告是单文件交互页
拉完片之后,输出是一个交互式 HTML 报告:内嵌播放器(播放时同步高亮当前镜头、点镜头跳转)、镜头节奏带、可搜索可筛选可排序的镜头表(列表/卡片两种视图、首尾关键帧并排、点图开大图)、统计分布、出场人物、质量检查结果。
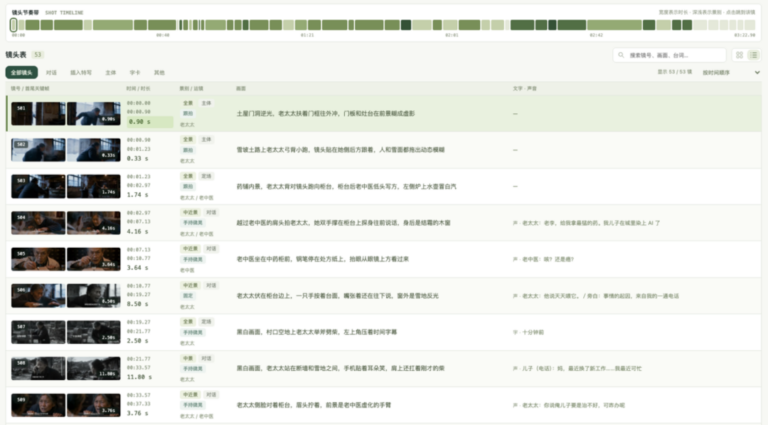
样式和交互代码直接内联在报告里——想改版式不用碰生成器,改 CSS 就行。
05 分镜合成:画面一边,信息一边
video-sync 把拉片数据变成一条能直接看的视频。
横版片子:画面在上,分镜信息在下。
竖版片子:画面在左,信息在右。
镜头切了信息跟着切,列表往上滚,高亮跟着滑。
06 为什么 0 成本能跑
这个 skill 的核心设计原则就是:能算的不问模型,模型只管定性判断。
ffmpeg 做场景检测和帧间差分——免费。
模型只做景别、运镜、画面描述——每个镜头一句判读,token 消耗极低。
15 道质量门全代码实现——免费。
报告生成交互式 HTML——免费。
没有 RAG,没有 embedding,没有向量数据库,没有第三方 API 调用。
写在最后
大多数同类工具走的是——AI 帮你做视频。
reelbench-skills 走的是反方向:AI 帮你分析已经存在的视频。
它对谁有用?做影视解说的、做拉片教学的、做视频内容分析的——都需要逐镜头拆解一条片子。
GitHub:https://github.com/eternityspring/reelbench-skills
📖 相关推荐


资深互联网从业者,专注AI工具研究与实战应用。长期跟踪ChatGPT、Claude、Stable Diffusion等前沿AI技术,擅长将复杂的技术概念转化为通俗易懂的教程。运营颜资源小站,致力于为中文用户提供高质量的AI教程、开源项目推荐和数字资源整理。
评论(0)