
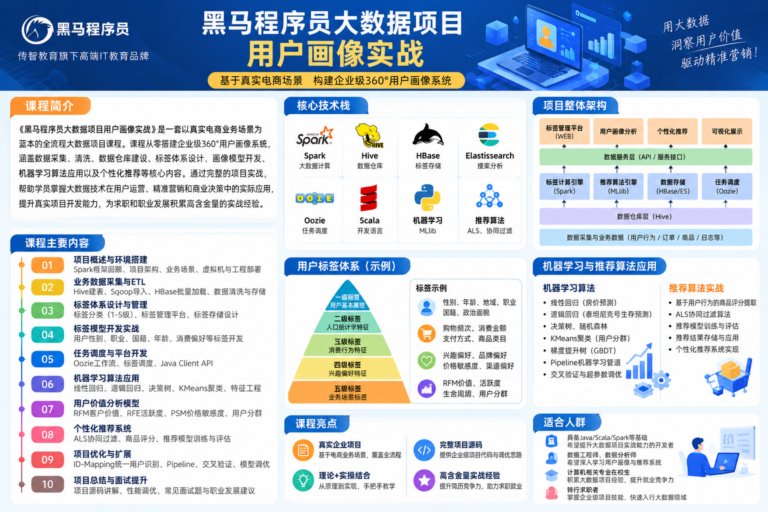
《黑马程序员大数据项目用户画像实战》是一套以企业级360°用户画像系统为核心的大数据开发实战教程。课程通过真实电商业务场景,将Spark、Hive、HBase、Elasticsearch、机器学习及推荐算法等技术融入完整项目,系统讲解从业务数据采集、ETL处理、标签体系设计、画像模型开发到用户价值分析与个性化推荐的全过程。整套课程包含10个阶段、数百节教学视频,注重理论与代码实操相结合,帮助学习者理解大数据技术在企业精准营销、用户运营及商业决策中的实际应用。
课程首先从Spark框架基础回顾入手,介绍企业级用户画像的整体架构、数据仓库与推荐系统之间的关系,深入分析用户画像的应用场景及标签分类方法。通过搭建标签管理WEB平台,学习一级至五级标签体系的设计思路,并完成项目环境部署、工程导入及业务数据初始化。同时结合Hive、Sqoop、HBase等组件,详细讲解数据迁移、批量加载、BulkLoad优化及标签数据存储方案,掌握企业级数据处理的基本流程。
在核心开发环节,课程围绕用户性别、职业、国籍、年龄段、消费周期、支付方式、订单金额等业务标签展开实战,利用Spark SQL、DataFrame、UDF及HBase完成标签计算、数据读取与结果存储。进一步介绍模板方法设计模式、标签模型基类封装、自定义HBase外部数据源及动态过滤条件处理,帮助学员建立标准化、可复用的标签开发体系。同时结合Oozie工作流调度,实现标签任务的自动执行与统一管理。
随着课程深入,重点转向机器学习算法在用户画像中的应用。通过Spark MLlib学习线性回归、逻辑回归、决策树、KMeans聚类等算法,并结合鸢尾花分类、房价预测及泰坦尼克号生存预测案例掌握特征工程、模型训练与评估方法。在用户价值分析方面,重点讲解RFM客户价值模型、RFE用户活跃度模型及PSM价格敏感度模型,通过用户消费行为、访问日志和价格偏好等数据构建多维度画像,实现用户分群与价值识别。
课程后续还深入介绍ID-Mapping统一用户识别、USG用户购物性别模型、随机森林、梯度提升树、Pipeline机器学习管道,以及交叉验证和超参数调优等进阶技术。最后结合ALS协同过滤算法构建用户购物偏好模型,完成商品评分提取、推荐模型训练、效果评估及推荐结果存储,进一步理解用户画像与个性化推荐系统的结合方式。
本课程适合具备Java、Scala、Spark或大数据基础,希望提升项目开发能力的程序员、数据工程师及求职学习者。通过系统学习,可以掌握企业级用户画像系统的技术架构、标签开发流程、机器学习建模及推荐算法应用,积累完整的大数据项目实战经验,为从事大数据开发、用户画像分析、数据挖掘及推荐系统相关工作奠定坚实基础。
📖 相关推荐

资深互联网从业者,专注AI工具研究与实战应用。长期跟踪ChatGPT、Claude、Stable Diffusion等前沿AI技术,擅长将复杂的技术概念转化为通俗易懂的教程。运营颜资源小站,致力于为中文用户提供高质量的AI教程、开源项目推荐和数字资源整理。
评论(0)