
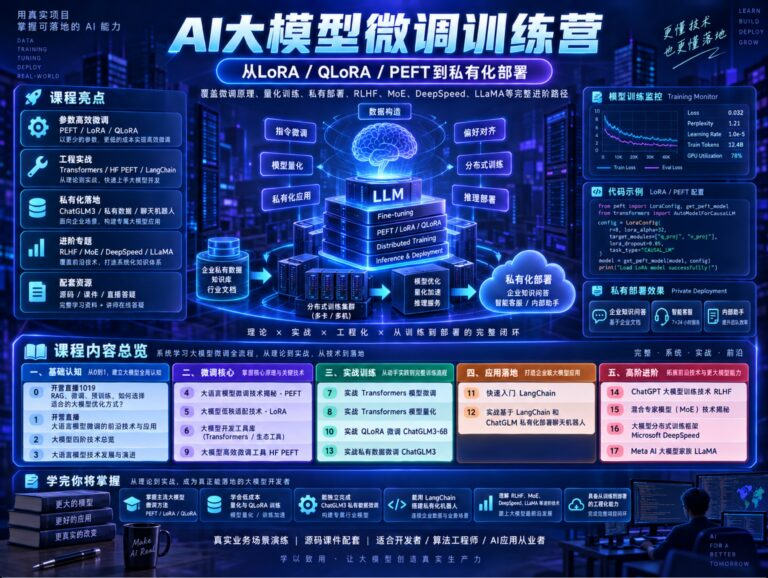
《极客时间-finetuning AI大模型微调训练营》是一套面向AI开发者、算法工程师、大模型应用工程师以及希望深入模型训练领域学习者打造的系统化实战课程。课程并不局限于调用大模型API或编写Prompt,而是进一步深入模型内部,从大语言模型的发展路线、微调原理、参数高效训练,到量化、私有数据训练、RLHF、分布式训练以及私有化应用部署,完整呈现“大模型如何被定制成行业模型”的技术路径。整套资源共包含36个文件夹,并配有大量高清视频、源码和相关课件,适合希望从AI应用层继续向大模型训练与工程化方向进阶的学习者。
课程前半部分首先帮助学员建立完整的大模型技术认知。从“大模型四阶技术总览”“大语言模型技术发展与演进”等内容入手,梳理预训练、微调、RAG等不同优化路线之间的区别,并结合实际业务场景分析什么时候应该使用知识库增强,什么时候应该选择模型微调。随后课程重点进入PEFT参数高效微调体系,深入讲解LoRA低秩适配的核心原理,以及为什么LoRA能够在冻结大部分模型参数的情况下,只训练少量参数就实现模型能力迁移。对于GPU资源有限、无法承担全参数训练成本的个人开发者和中小团队来说,这部分具有非常强的实用价值。
进入实战阶段后,课程会结合Hugging Face Transformers、HF PEFT等主流大模型开发工具进行完整演练。从模型加载、Tokenizer处理、数据集整理、训练参数设置,到Trainer训练流程、模型保存以及效果验证,逐步带领学习者完成真实的大模型微调项目。同时课程专门安排Transformers模型量化以及QLoRA微调ChatGLM3-6B实战,通过量化降低显存占用,再结合LoRA实现低成本微调,让学习者理解如何在有限硬件条件下训练数十亿参数规模的大语言模型。
课程后续内容进一步延伸到企业级应用场景,包括使用私有数据微调ChatGLM3、通过LangChain构建大模型应用,以及基于LangChain与ChatGLM搭建私有化聊天机器人。学习者不仅能够掌握模型训练,还能进一步了解如何将训练后的模型接入知识库、业务系统和聊天应用,完成从“模型能力”到“实际产品”的落地闭环,对于企业知识助手、智能客服、行业问答、内部文档分析等项目都具有较高参考价值。
在高级部分,课程还覆盖RLHF人类反馈强化学习、MoE混合专家模型、Microsoft DeepSpeed分布式训练框架以及Meta LLaMA大模型家族等重要技术。通过这些章节,可以继续理解ChatGPT类模型在指令对齐、偏好优化方面的训练思路,以及大型模型如何通过多GPU、多节点完成分布式训练。MoE章节则帮助学习者理解越来越多大模型采用的专家混合架构,为进一步研究大模型底层架构和训练优化打下基础。
整体来看,这套训练营最大的特点是“原理+工具+实战+应用”结合较为完整。它既讲PEFT、LoRA、QLoRA、RLHF等关键原理,又通过Transformers、HF PEFT、DeepSpeed、LangChain、ChatGLM、LLaMA等主流技术栈进行真实项目演练。对于已经掌握Python基础、会调用大模型API,但希望继续学习模型微调、私有化部署和企业级AI项目开发的人来说,这套课程能够帮助建立更加完整的大模型工程能力体系。从数据准备到模型训练,从量化优化到私有部署,再到聊天机器人和垂直领域模型落地,课程覆盖了大模型微调方向中非常核心的一条技术成长路线。
📖 相关推荐

资深互联网从业者,专注AI工具研究与实战应用。长期跟踪ChatGPT、Claude、Stable Diffusion等前沿AI技术,擅长将复杂的技术概念转化为通俗易懂的教程。运营颜资源小站,致力于为中文用户提供高质量的AI教程、开源项目推荐和数字资源整理。
评论(0)